
近日,DeepSeek 宣布其核心算子开发产品 TileLang 正式原生支持华为昇腾 950 NPU,并同步推出 DeepGEMM、DeepEP、FlashMLA、TileKernels、DeepSelect 五大核心计算与通信库的昇腾版本。这一举措标志着国产算力在核心算子工具层面首次实现了与英伟达生态的能力对标,为打破长期存在的 CUDA 绑定困境提供了关键路径。
终结算子开发“手工作坊”模式
在 AI 底层开发中,算子编写一直是高门槛、高耗时的工作。若底层算子优化不足,芯片内部计算单元常因等待数据流转而闲置,导致硬件利用率可能仅维持在 20% 左右。传统开发路径存在明显局限:手写 CUDA 性能高但开发效率低且绑定英伟达生态;厂商预制算子库如 cuBLAS 虽性能稳定但灵活性差,难以适配新算法;高层 DSL 编译器如 Triton 虽降低门槛,但对非英伟达硬件支持度低。
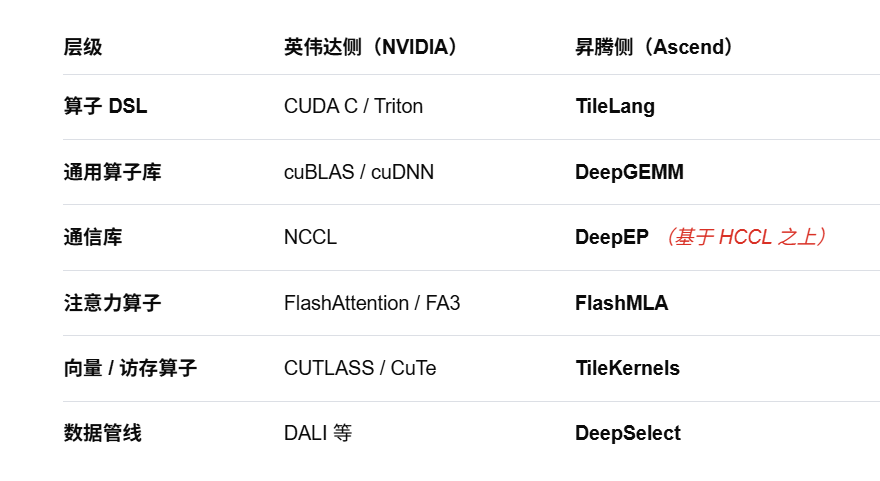
TileLang 通过多级分块(Tiling)机制,将庞大计算任务切分为标准化数据块,开发者只需声明数据计算位置,编译器即可自动完成数据搬运与线程同步。这种模式兼顾了开发灵活性、运行性能与跨平台能力,旨在将硬件利用率提升至 95% 以上。该工具主要覆盖通用矩阵乘法、反量化 GEMM、FlashAttention 等大模型核心算子,这些算子承载了大模型训练和推理 90% 以上的计算量。
基于 TVM 架构实现高性能跨平台适配
TileLang 并非从零构建,而是复用 Apache TVM 的编译能力。TVM 作为开源机器学习编译器框架,充当 AI 芯片与大模型之间的“翻译官”。TileLang 在 TVM 基础上封装了简化的语法,由北京大学团队孵化后,经 DeepSeek 推至生产环境并捐赠开源。截至 2026 年 9 月,该仓库已获得 7.6k stars 和 1,992 次 commit。
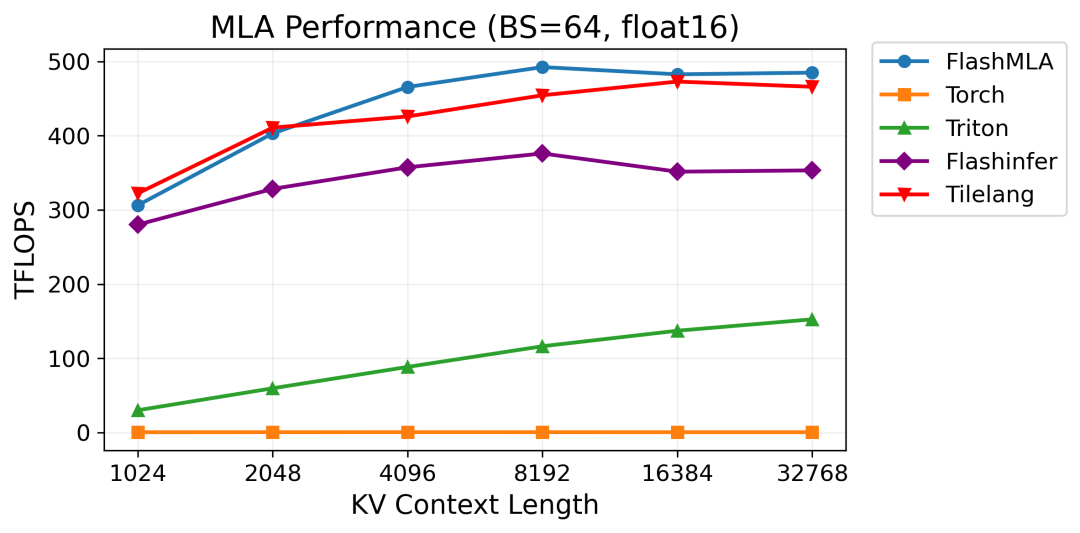
性能数据显示,基于 TileLang 优化的 DeepSeek V3.2 稀疏注意力 TopK 算子比原生 PyTorch 快 2–20 倍。在英伟达 H100 上,其 MLA、FlashAttention 等核心算子性能超越 Meta 的 PyTorch 原生实现及 OpenAI 的 Triton,并追平英伟达官方 cuBLAS 及 FlashAttention。此外,TileLang 在 AMD MI300X 上也能达到接近硬件极限的性能,展现了强大的跨平台能力。
前后端解耦架构支撑多芯片运行
TileLang 采用“前后端解耦,目标与执行分离”的架构。目标后端负责定义特定硬件的指令语法和优化规则,执行后端则处理通用的编译、加载和启动流程。适配新芯片时,仅需新增目标后端,无需改动执行后端。每个目标后端遵循四层流水线结构,包括语言方言、上下文贡献、Pass 流水线及主机/设备代码生成。
- 语言方言层将代码翻译为特定芯片指令,如英伟达 CUDA 的 WGMMA、AMD ROCm 的 MFMA 及华为昇腾的 Ascend C 指令;
- 上下文贡献层统一转换硬件规格参数并记录编译状态;
- Pass 流水线进行核心逻辑转换与芯片特定优化;
- 代码生成层将代码拆分为 CPU 调度的主机侧代码和加速器执行的设备侧代码。
目前,TileLang 已覆盖英伟达 CUDA、AMD ROCm、苹果 Metal、华为昇腾 950 等主流平台,并适配沐曦、摩尔线程等国产芯片。开发者可通过简洁的 Python 语法,对存储控制、线程调度及并行节奏进行显式操控,将传统 CUDA 实现中 500 行以上的代码压缩至 30 多行。
深化国产算力生态布局
据《The Information》报道,DeepSeek 创始人梁文锋在 9 月 21 日的投资人闭门会上表示,使用华为或其他国产芯片训练模型是公司当前“最大的赌注之一”,并强调此役“必须成功”。此前彭博社报道指出,DeepSeek 已投入 25.6 亿美元采购至少 16 万颗华为昇腾 950DT 加速器。通过开源 TileLang 及其配套工具链,DeepSeek 不仅提升了自身模型在国产算力上的效率,也为行业构建了自主可控的底层软件生态,降低了大模型训练与推理的算力成本,推动了 AI 基础设施从单一依赖向多元化、自主化方向演进。