
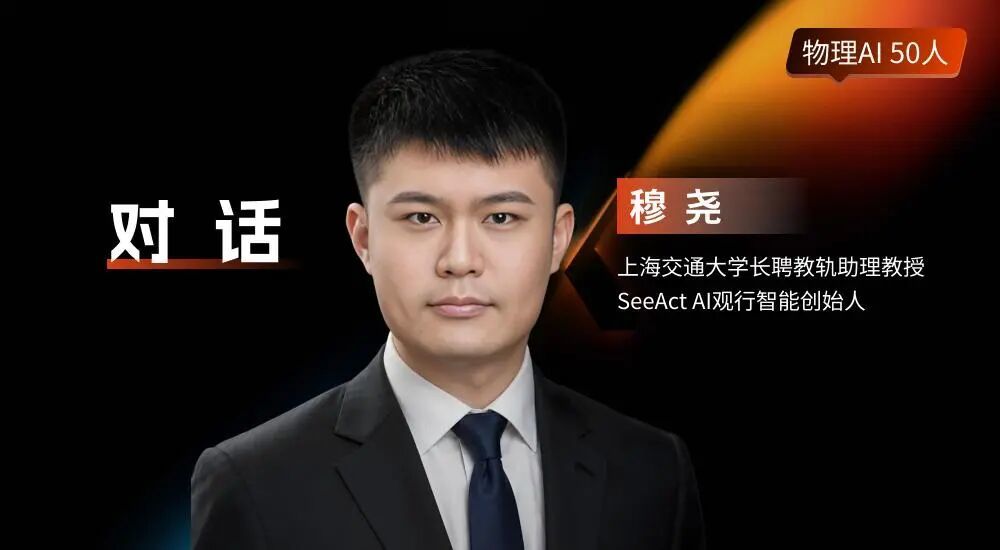
2026年,前上海交通大学长聘教轨助理教授、国家级青年人才计划入选者穆尧创办了SeeAct AI(观行智能)。这家新公司押注“具身自我进化”,旨在解决当前具身智能领域缺乏有效经验积累机制的痛点。穆尧指出,机器人真正缺少的不是海量数据,而是从交互中提炼出的有效经验,具身智能的终局将从被动的“被训练”走向主动的“自我进化”。
RoboTwin确立行业基准
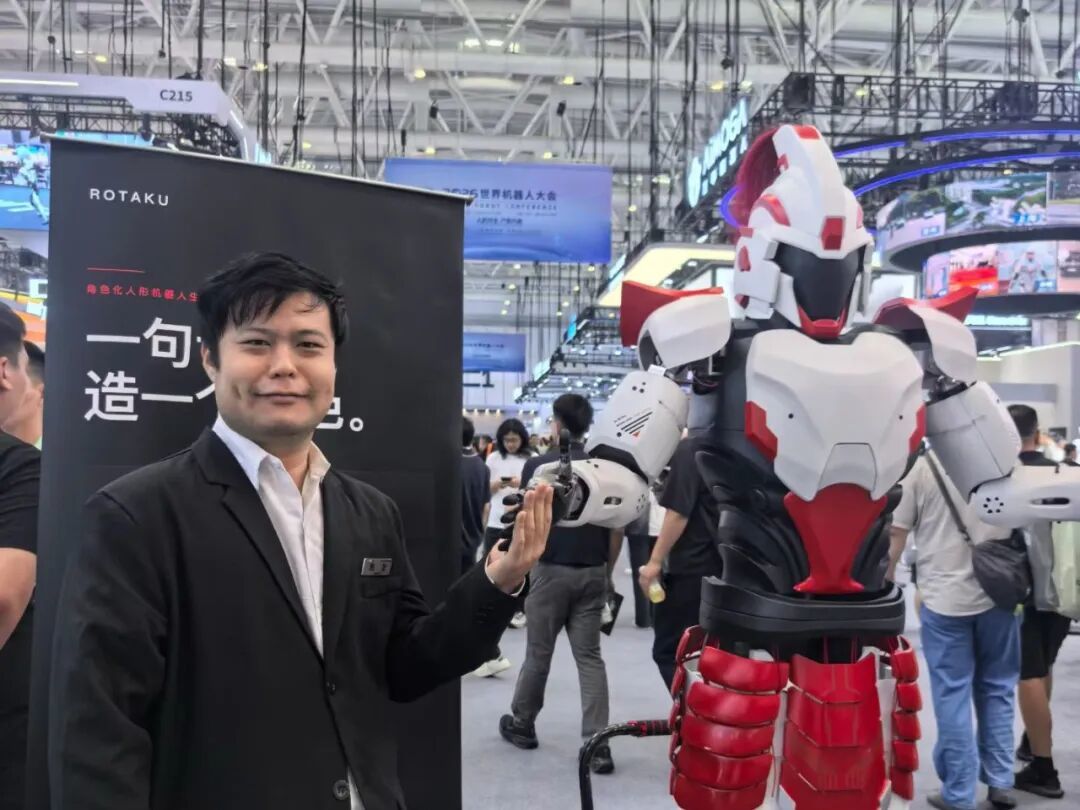
在创办新公司之前,穆尧在具身智能领域已建立了显著的影响力。他主导研发的开源项目RoboTwin已成为中国具身智能圈的事实标准之一,在GitHub上斩获超过2900颗星。该基准测试被蚂蚁集团的LingBot-VA、生数科技的Motubrain等头部厂商广泛采用,用于刷新技术成绩。穆尧的学术成果同样丰硕,其谷歌学术引用次数超过5000次。
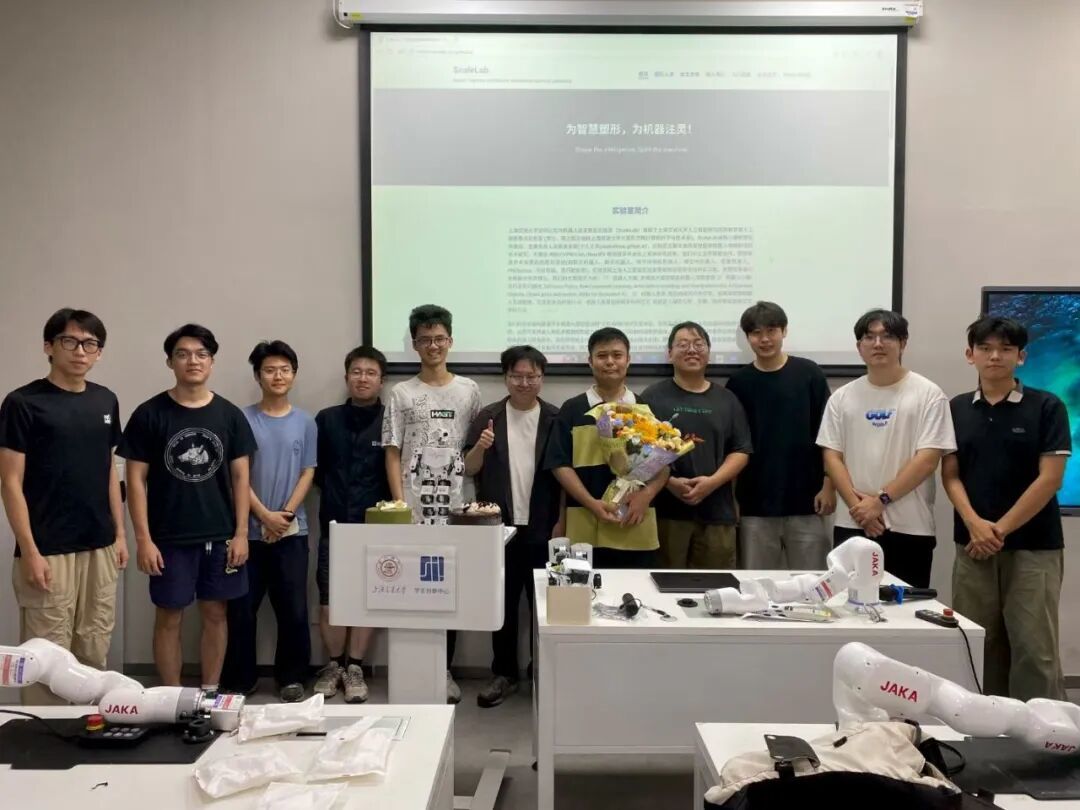
RoboTwin的发展经历了从1.0到3.0的迭代。从最初提供仿真数据管线,到2.0版本将任务规模扩大至50个并升级行为生成,再到3.0版本与摩尔线程合作支持国产显卡和物理引擎,RoboTwin构建了一个开放且兼容多硬件生态的Benchmark和数据生成器。这一系列工作为行业提供了标准化的评估环境和数据基础。
经验规模化是核心瓶颈
穆尧认为,当前具身智能的竞争主要集中在数据量(Data Scaling)和模型规模(Model Scaling)两个维度,但普遍忽视了第三层关键要素:经验规模化(Experience Scaling)。人类智能的提升依赖于在物理世界中的持续交互,机器人亦然。仅靠人类演示数据,机器人只能学习“人在特定情况下怎么做”,无法掌握执行过程中的细微差异,如抓取时的打滑、力度调整及失败后的应对策略。
经验规模化强调机器人需具备自主探索能力,通过与环境的交互持续产生对新策略有用的新经验。这种经验不仅包括交互的数量,更涵盖经验覆盖的范围及其对能力提升的价值。穆尧指出,只有建立持续产生经验的机制,机器人才能从“模仿者”转变为真正的“智能体”,从而推动具身智能从实验室走向实际落地。
奖励驱动实现递归进化
SeeAct AI的核心技术路线是“奖励驱动的自我进化”。穆尧将其定义为递归自我进化(Recursive Self-Improvement),即机器人通过一轮提升后,能够利用新获得的能力去解决更复杂的问题,进而产生更高质量的经验,形成正向循环。这一过程依赖于奖励信号,通过任务结果和环境反馈,让系统判断哪些尝试更有效,并据此更新策略。
这种进化发生在不同层面:底层涉及具体操作策略的更新,如调整抓取位置;上层涉及任务规划和决策逻辑的优化,如调用不同的技能模块。穆尧强调,关键在于一次交互带来的收获能被保留并在后续任务中发挥作用。这一理念源于他早在2018年硕士阶段对端到端Policy和奖励驱动的坚持,如今这一判断在具身智能领域得到了更深刻的验证。
具身智能正处于从技术验证向应用落地过渡的关键阶段。SeeAct AI通过聚焦经验规模化与自我进化,试图打破当前依赖大规模人类数据训练的瓶颈。随着机器人硬件能力的提升,如何高效利用交互数据实现能力的指数级增长,将成为行业竞争的核心焦点。穆尧的判断表明,未来领先的具身智能系统,必将是那些能够像人类一样,通过不断试错和反思实现自我进化的系统。