
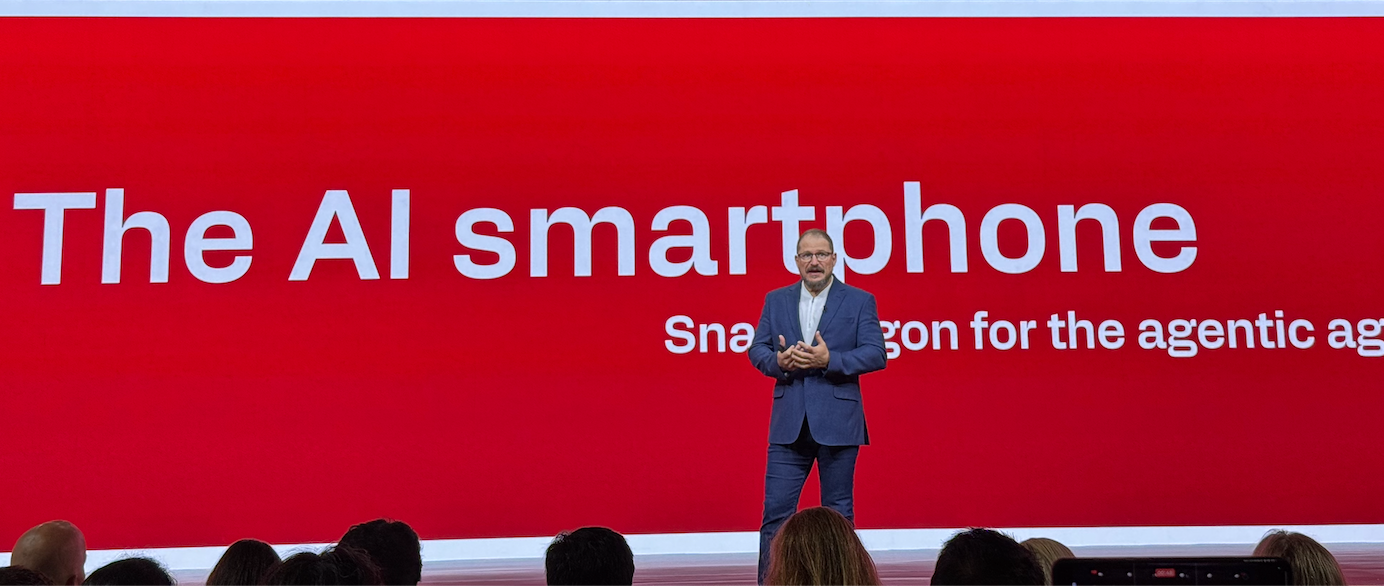
2026年骁龙峰会上,高通公司正式发布了第六代骁龙8超级至尊版与第六代骁龙8至尊版两款2nm制程移动旗舰平台。高通总裁兼CEO安蒙指出,行业正从以手机为中心的模式转向以智能体为中心的新体验,手机、PC、眼镜及汽车将成为智能体的终端入口。为了适应智能体持续感知、理解上下文并代表用户执行任务的需求,高通重新设计了计算引擎架构,旨在解决端侧AI面临的内存墙与能效挑战。
打破内存墙,重构CPU、GPU与NPU架构
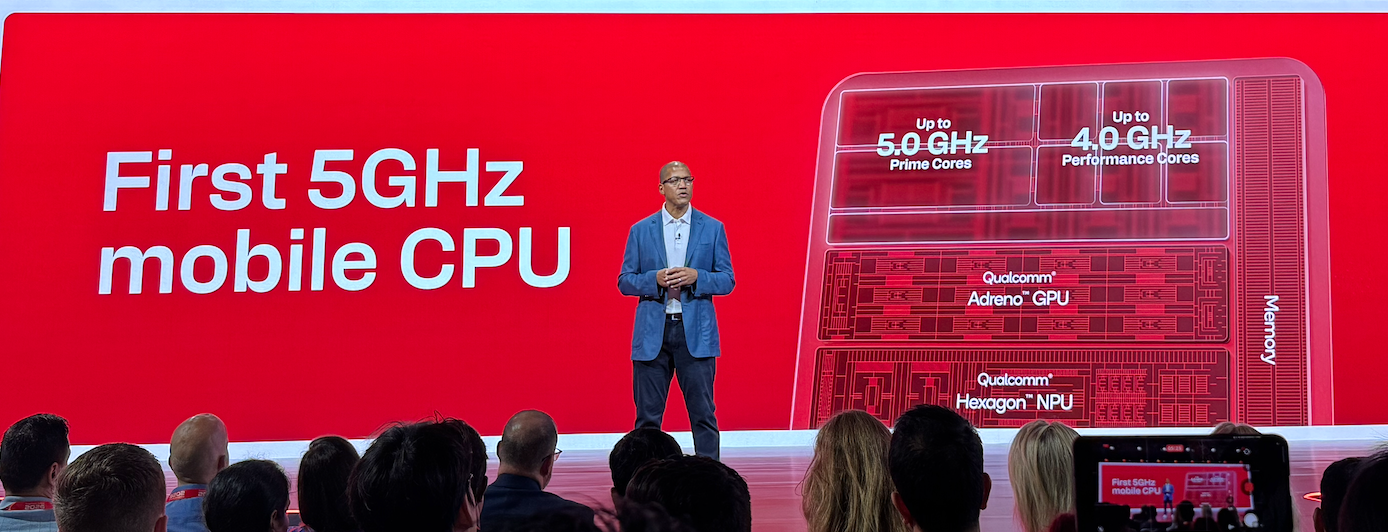
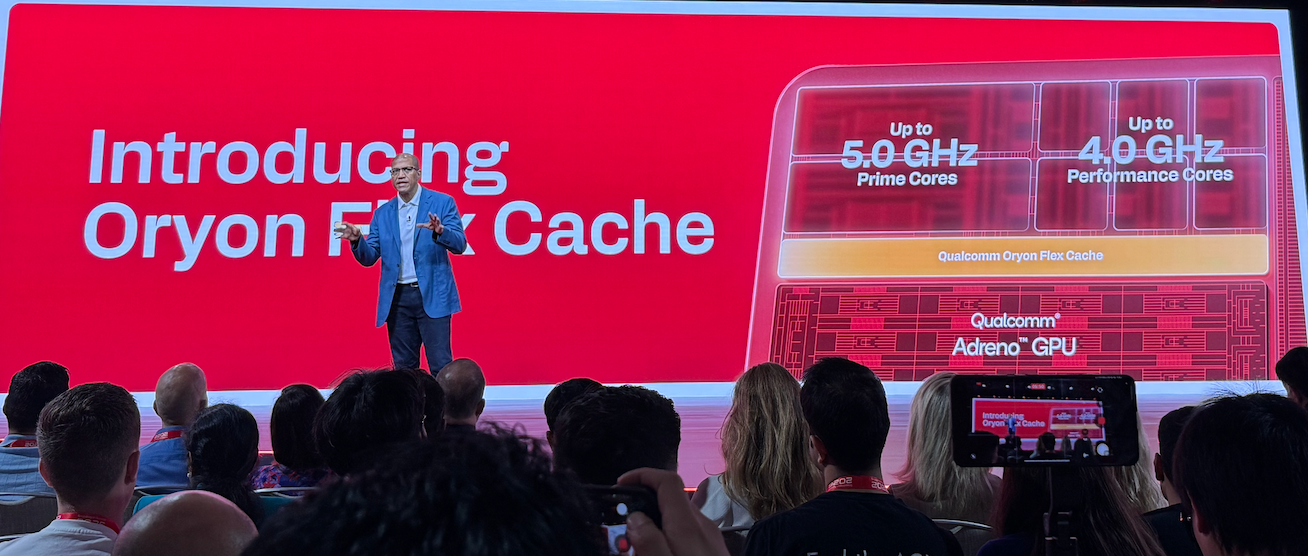
针对智能体全天运行带来的数据搬运压力,第六代骁龙8超级至尊版对核心组件进行了全面升级。其搭载的最高主频达5GHz的Oryon CPU引入了全新Oryon FlexCache技术,让8个核心访问同一个共享L2缓存池,根据工作负载动态分配资源,从而减少任务切换时的数据重新加载时间,缩短决策链中的等待延迟。
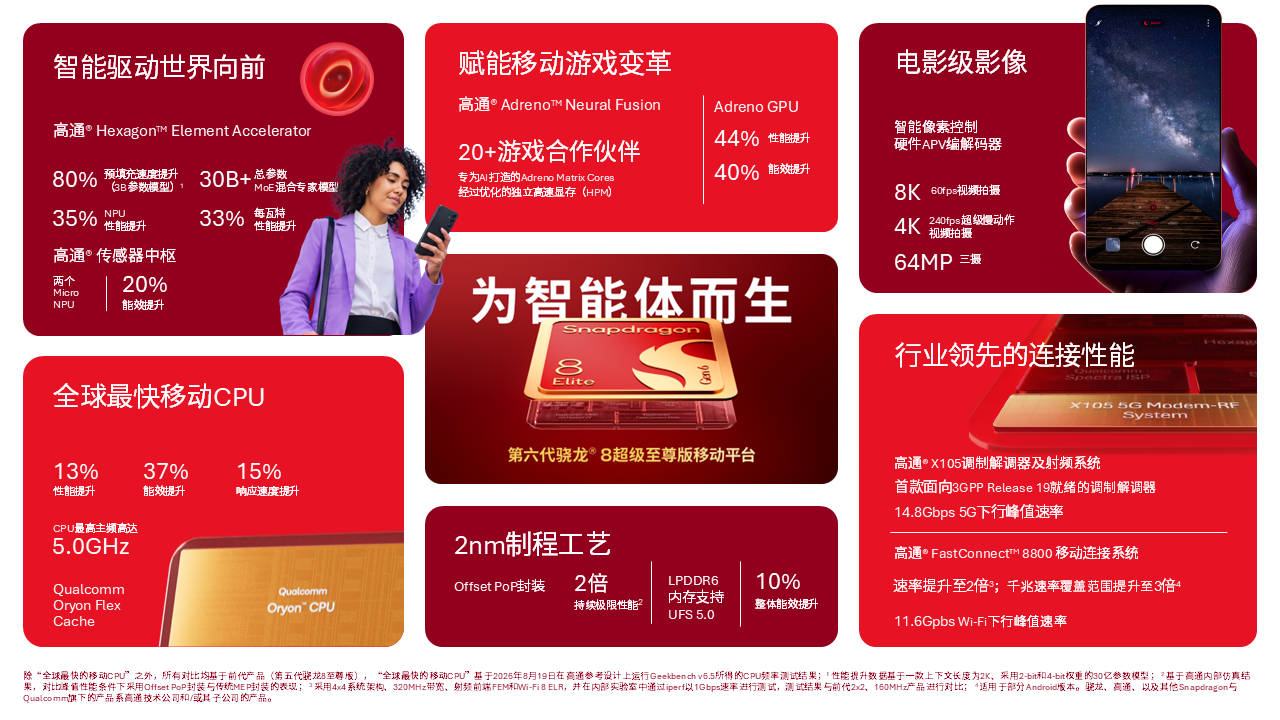
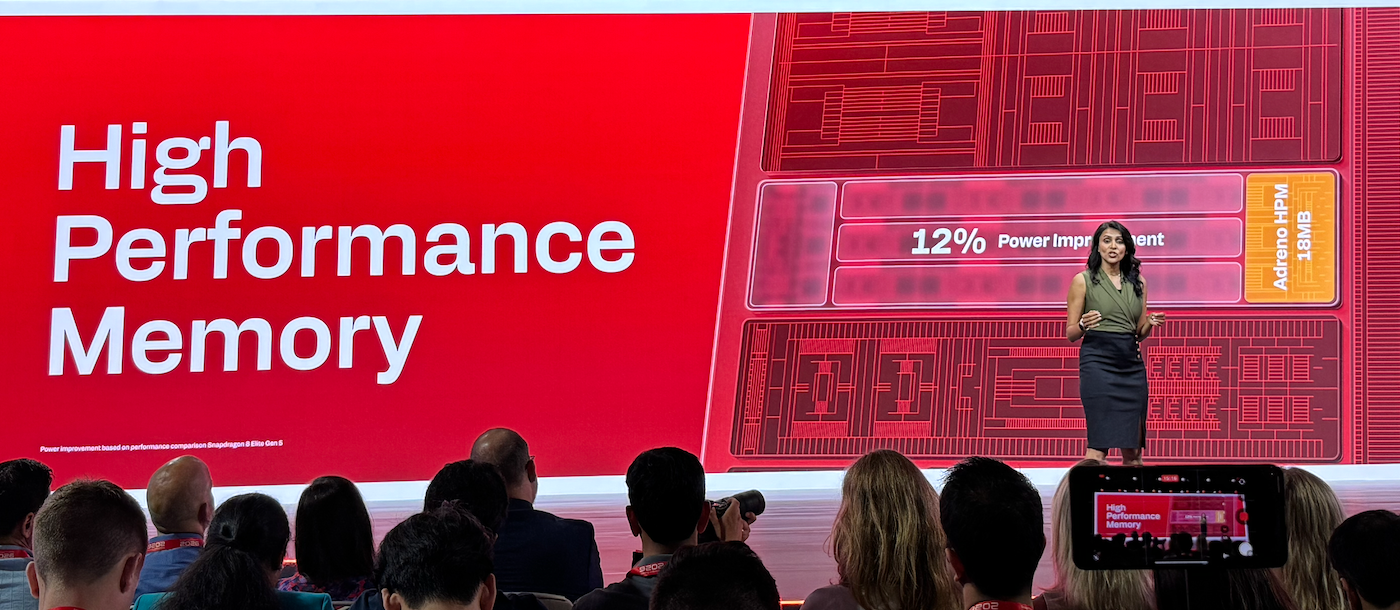
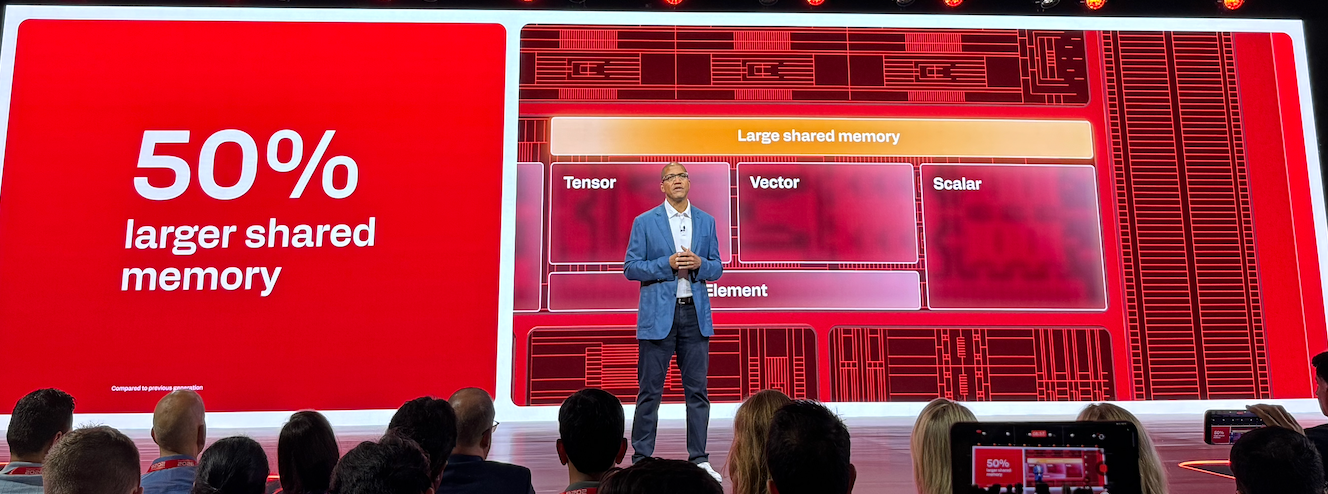
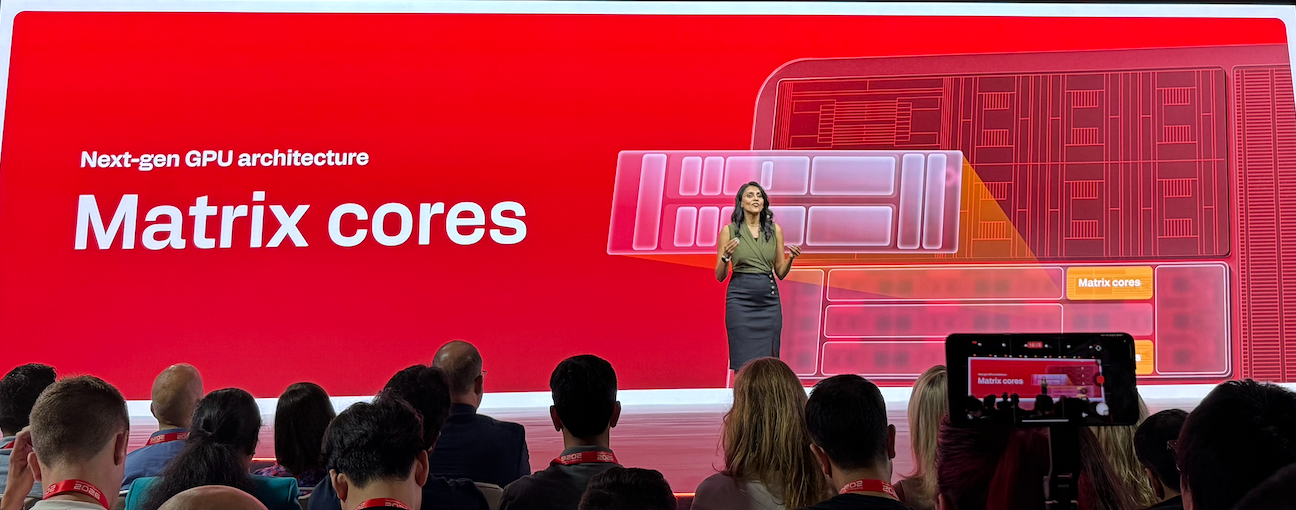
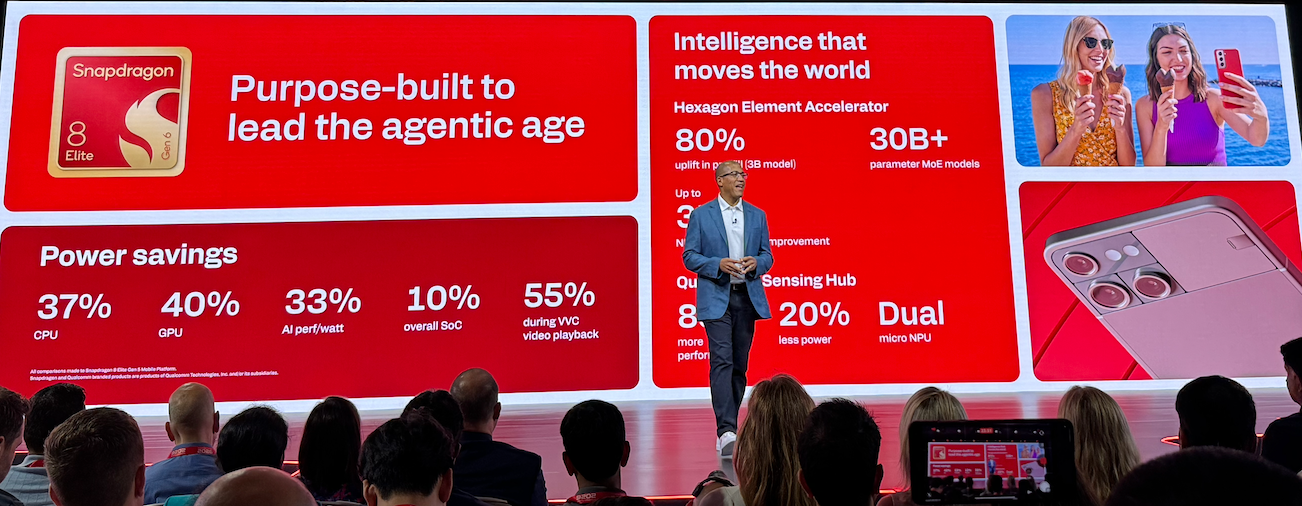
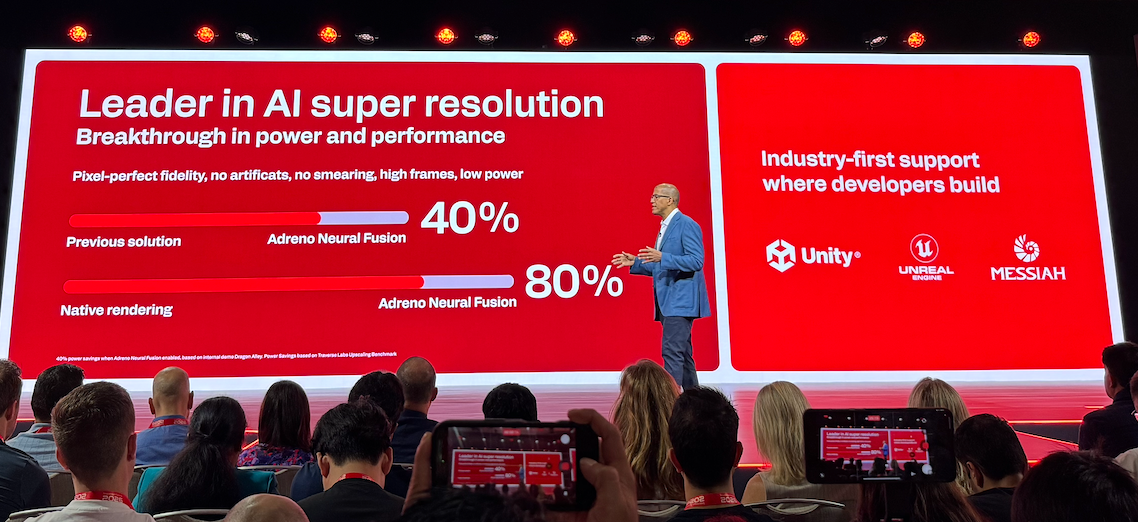
在图形与AI加速方面,Adreno GPU首次加入Matrix Cores(矩阵核心),并配备第二代18MB独立高速显存HPM,使图形管线功耗降低12%。Hexagon NPU的共享内存增加50%,让模型状态和KV-cache更多保留在片上,降低外部DDR访问频率。此外,该平台还采用LPDDR6内存和UFS 5.0闪存,从系统维度协同解决内存墙问题。
异构协同支持端侧运行300亿参数MoE模型
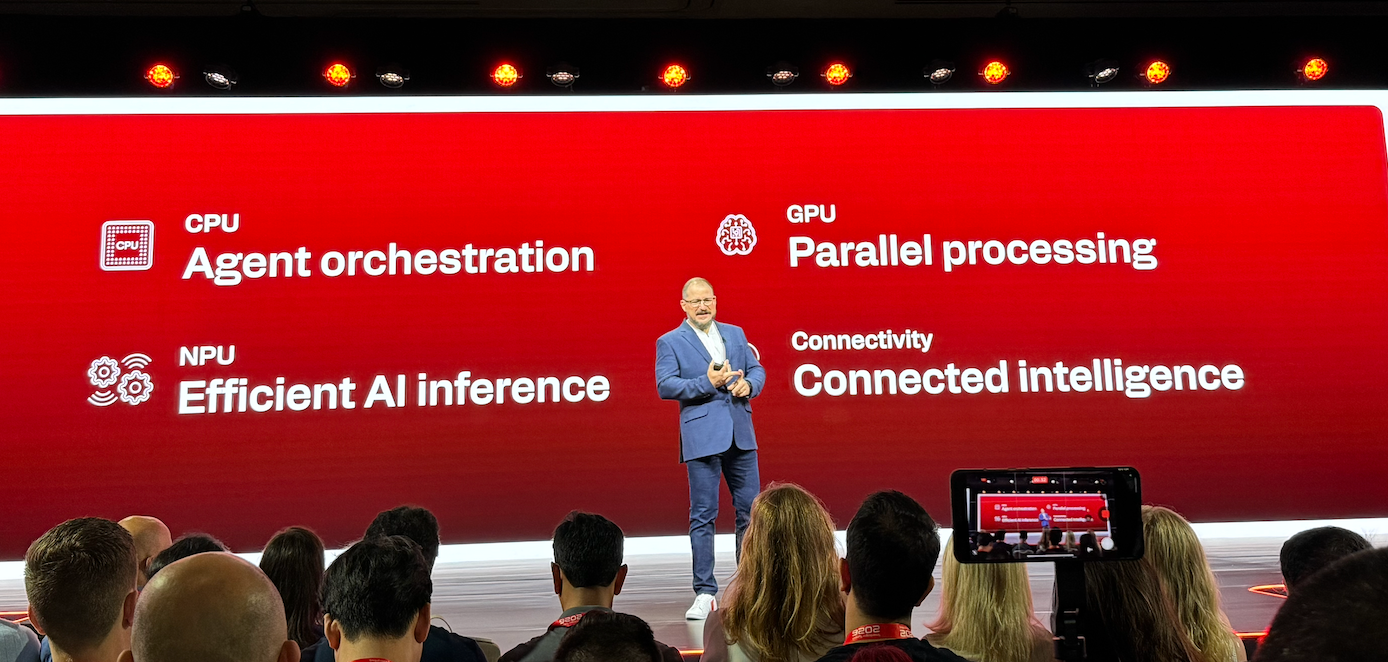
该平台的核心亮点在于能够端侧运行300亿参数MoE(混合专家)模型。通过CPU、GPU、NPU的异构调度,NPU负责主要推理与内容生成,GPU中的Matrix Cores加速图形管线内的AI任务,CPU则承担智能体编排与任务调度。Hexagon NPU加强了对Transformer的支持,支持最高32K Token上下文,部分模型预填充性能提升最高80%。
在实际部署中,高通与阶跃、无量火、江波龙合作,将StepEdge-Omni 30B-MoE完整部署至手机端。通过存算协同,模型运行内存需求较常规方案降低超过50%,预填充速度超过330 Token/s,解码速度超过28 Token/s。NPU与GPU双引擎协同的预填充吞吐性能相比仅使用NPU的方案提升超过30%,实现了从单次问答向完整智能体工作流的跨越。
构建跨终端智能体计算底座
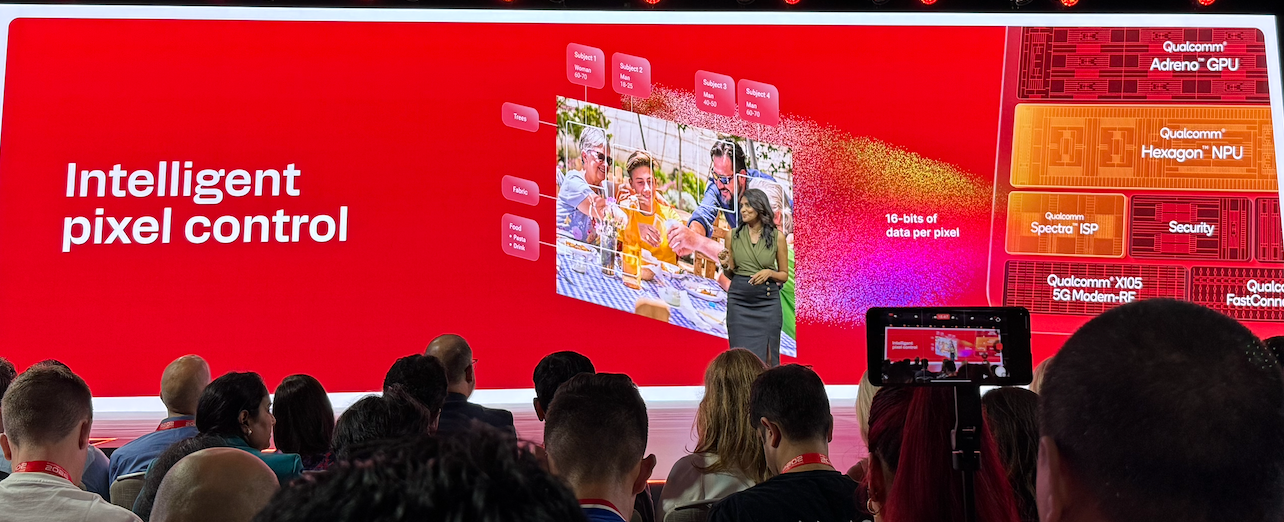
除了核心计算单元,传感器中枢的双Micro NPU在性能提升85%的同时功耗降低20%,支持智能体低功耗持续在线。Adreno GPU性能最高提升44%,能效最高提升40%,Spectra ISP第二代AI-ISP架构将视频吞吐能力提升2倍,并支持8K 60fps视频拍摄。
此次发布标志着高通的角色从提供移动计算平台延伸至搭建智能体AI的计算底座。随着计算产品组合扩展至PC、汽车等领域,高通致力于通过混合AI架构,让智能体在终端与云端之间保持连续,使用户在有限的电量与散热约束下,依然能获得自然、私密的个人AI体验。这预示着未来旗舰SoC的竞争标准将从峰值性能转向系统级的能效、内存管理与异构协同能力。