
随着大模型研发进入深水区,行业正从单纯追求模型能力的提升,转向探索“AI for AI”这一核心命题。当模型开始参与下一代模型的研发,传统的研发范式正在发生根本性变革。近期,Naive AI 等新兴力量通过重构中训练与后训练流程,展示了 AI 在自动化科研中的巨大潜力,这一领域正成为验证智能自我进化能力的关键试炼场。
AI for AI 成为巨头与初创共同押注的方向
过去两年,行业聚焦于编程与数学能力的突破,如今这些能力正被反哺至 AI 研发本身。2026 年,“AI for AI”已成为海外头部实验室的公开目标。OpenAI 成立 RSI 团队,计划在 2028 年 3 月前实现完全自动化的 AI 研究员;Anthropic 披露其内部 80% 以上的可运行代码由 AI 独立编写,工程师效率提升 8 倍,且核心平台有 30,000 个 AI Agent 同时协作。Google 则通过 AlphaEvolve 加速 Gemini 迭代,并调整高层战略聚焦 AGI 长期发展。在国内,面壁、智谱等企业也在不同环节引入 AI 参与研发,从预训练框架到推理基础设施,AI 接手的研发环节正逐步打通。
中训练与后训练成为 AI 研发最先落地的场景
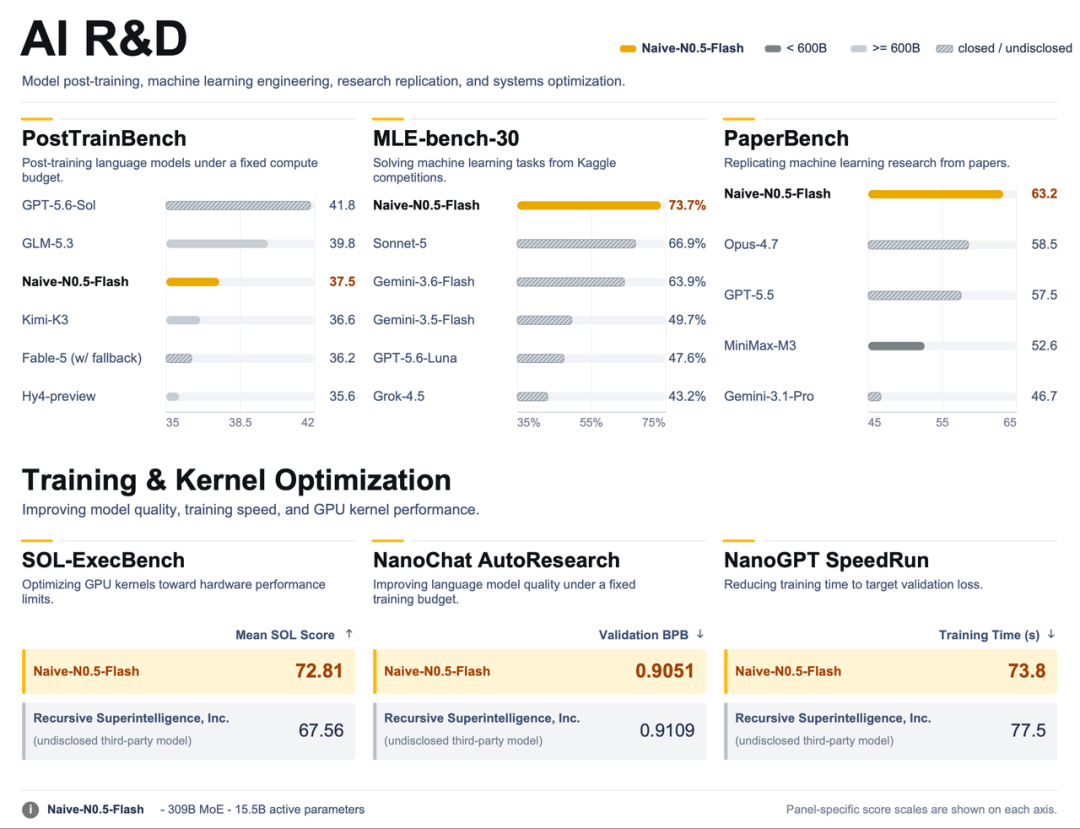
相较于周期长、投入大的预训练,中训练与后训练具有实验多、周期短、结果可快速评估的特点,因此成为 AI 大规模承担研发工作的起点。开源生态的成熟使得基于现有基座进行优化成为可能。智谱 GLM-5.3 便是典型案例,其沿用相同基座,仅通过强化学习等后训练手段,使内部编程评测成绩提升约 50%,证明了基座之后优化空间巨大。Naive AI 押注此路径,以开源基座为起点,重点投入中训练与后训练,旨在有限资源内不断突破性能边界。
Naive AI 重构研发体系实现模型快速迭代
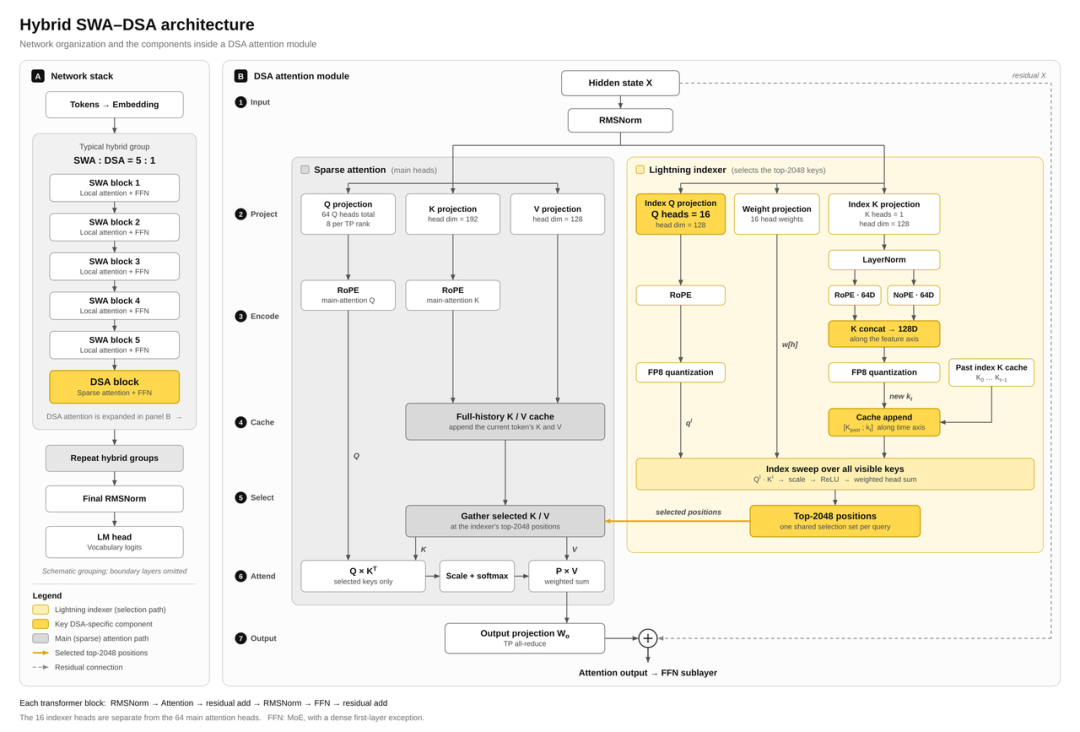
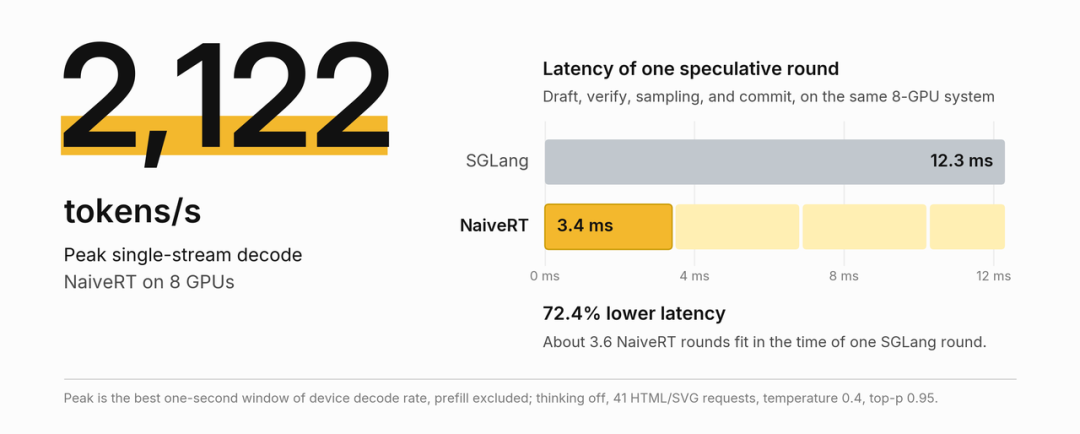
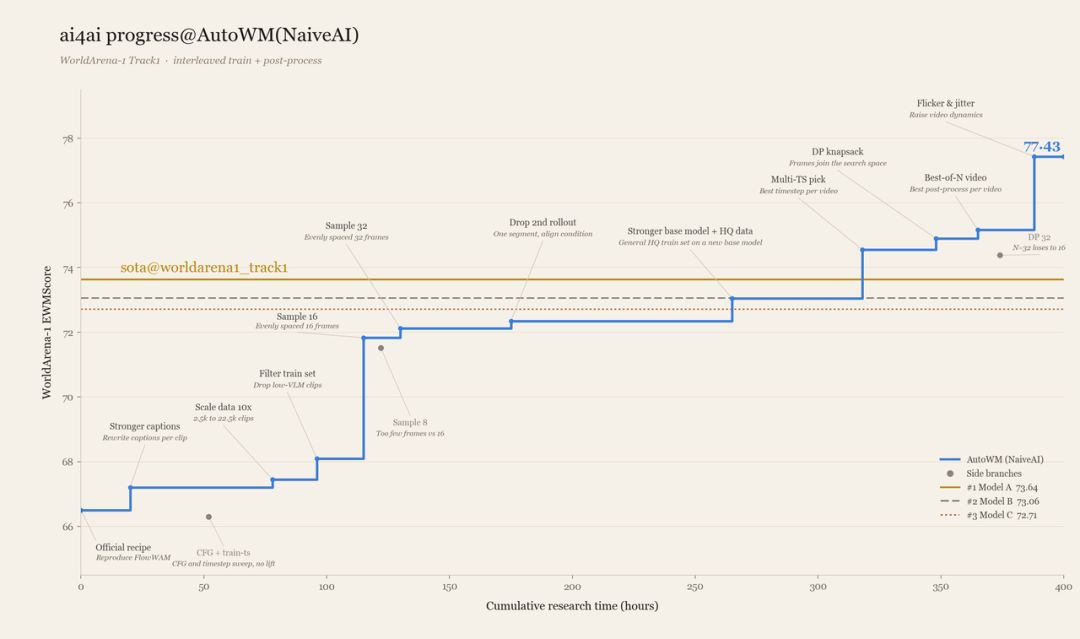
Naive AI 通过重构基座注意力架构,将全局注意力替换为稀疏注意力,形成 SWA 与 DSA 混合结构。为此,其模型 Naive-N0.5-Flash 在保持 1M 上下文的前提下,分阶段累计训练了 3.25T tokens。在此过程中,AI 不仅参与模型训练,还优化了训练系统本身:通过区分 DSA 与 SWA 层的通信需求降低开销,细化显存管理策略,并自主发现、定位及修复位置编码精度不足等底层 Bug。这种以 AI 为中心的研发基础设施,每周可运行近千万个沙箱,最多同时运行 10 万个,人类研究员则专注于目标设定与最终决策。
AI for AI 的兴起标志着大模型研发正从人工主导转向人机协同乃至 AI 主导的新阶段。中训练与后训练作为高频迭代环节,率先实现了 AI 的深度介入。Naive AI 的实践表明,通过自动化架构探索、训练优化与系统调试,研发效率得以数量级提升。这一趋势不仅加速了模型能力的进化,也为通往通用人工智能提供了一条可量化、可复制的技术路径,预示着智能体自我迭代将成为未来算力与算法竞争的核心驱动力。