
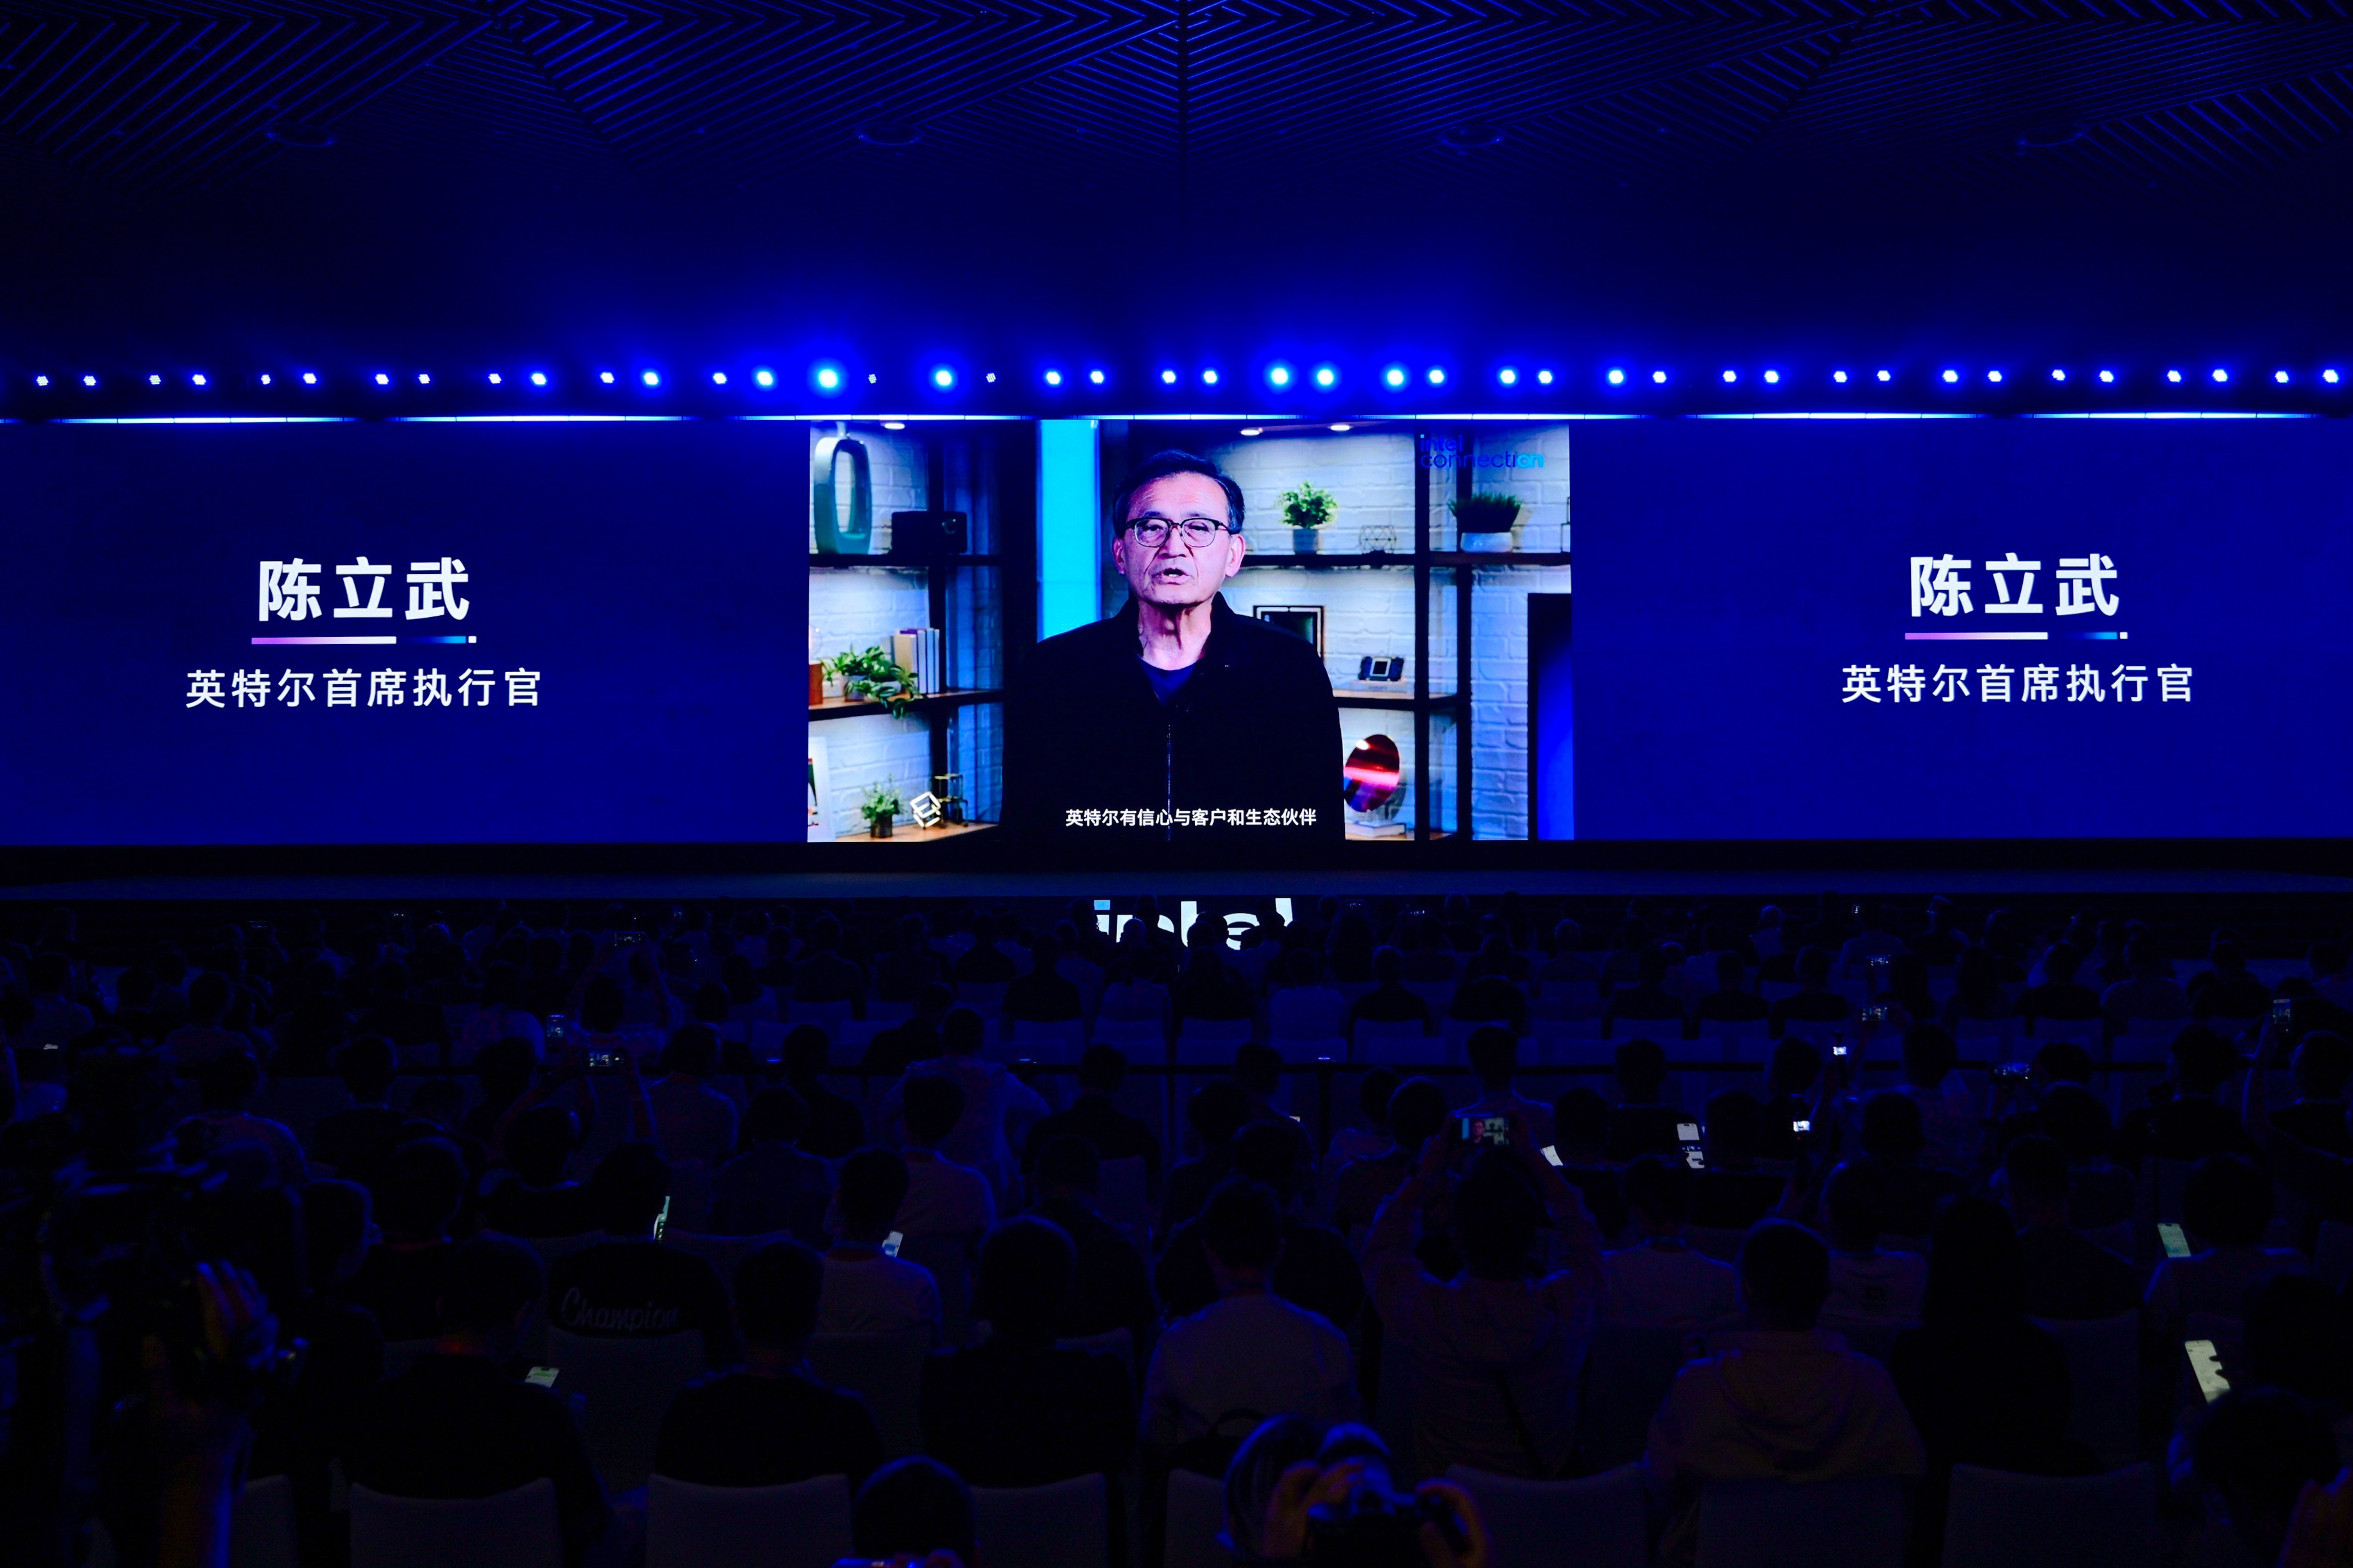
随着人工智能技术从单纯的大模型训练向复杂的智能体推理与物理世界交互演进,算力架构的重心正在发生深刻迁移。在9月22日举行的英特尔Connection大会上,英特尔明确指出,AI产业正从“算得快”迈向“干得了活”的新阶段,CPU在这一过程中正从辅助角色蜕变为系统的控制中枢,重新定义算力版图。
智能体规模化落地,CPU重构数据中心架构
在数字AI领域,智能体执行与传统模型训练存在本质差异。训练任务追求极致吞吐量,而智能体作为串行状态机,对端到端延迟的稳定性有极高要求。英特尔数据中心集团副总裁、中国区总经理陈葆立表示,未来的数据中心将拆分为CPU集群、GPU集群和存储集群,其中CPU集群负责智能体执行和任务编排,并承担三类集群间的数据调度。
为应对这一需求,英特尔推出了采用Intel 18A制程、最高拥有288个能效核的至强6+处理器。实测数据显示,在SWE-bench测试中,其单智能体性能领先竞品15%;在云端沙箱场景下,至强6+支持350个沙箱并发,性能约为竞品的1.46倍。此外,CPU在异构数据预处理、存储调度及KV Cache管理环节发挥关键作用,例如通过QAT将300GB原始数据压缩至200GB,数据搬运加速最高达9.66倍,有效解决了智能体规模化部署中的延迟与资源冲突问题。
物理AI突破控制瓶颈,异构SoC实现大小脑融合
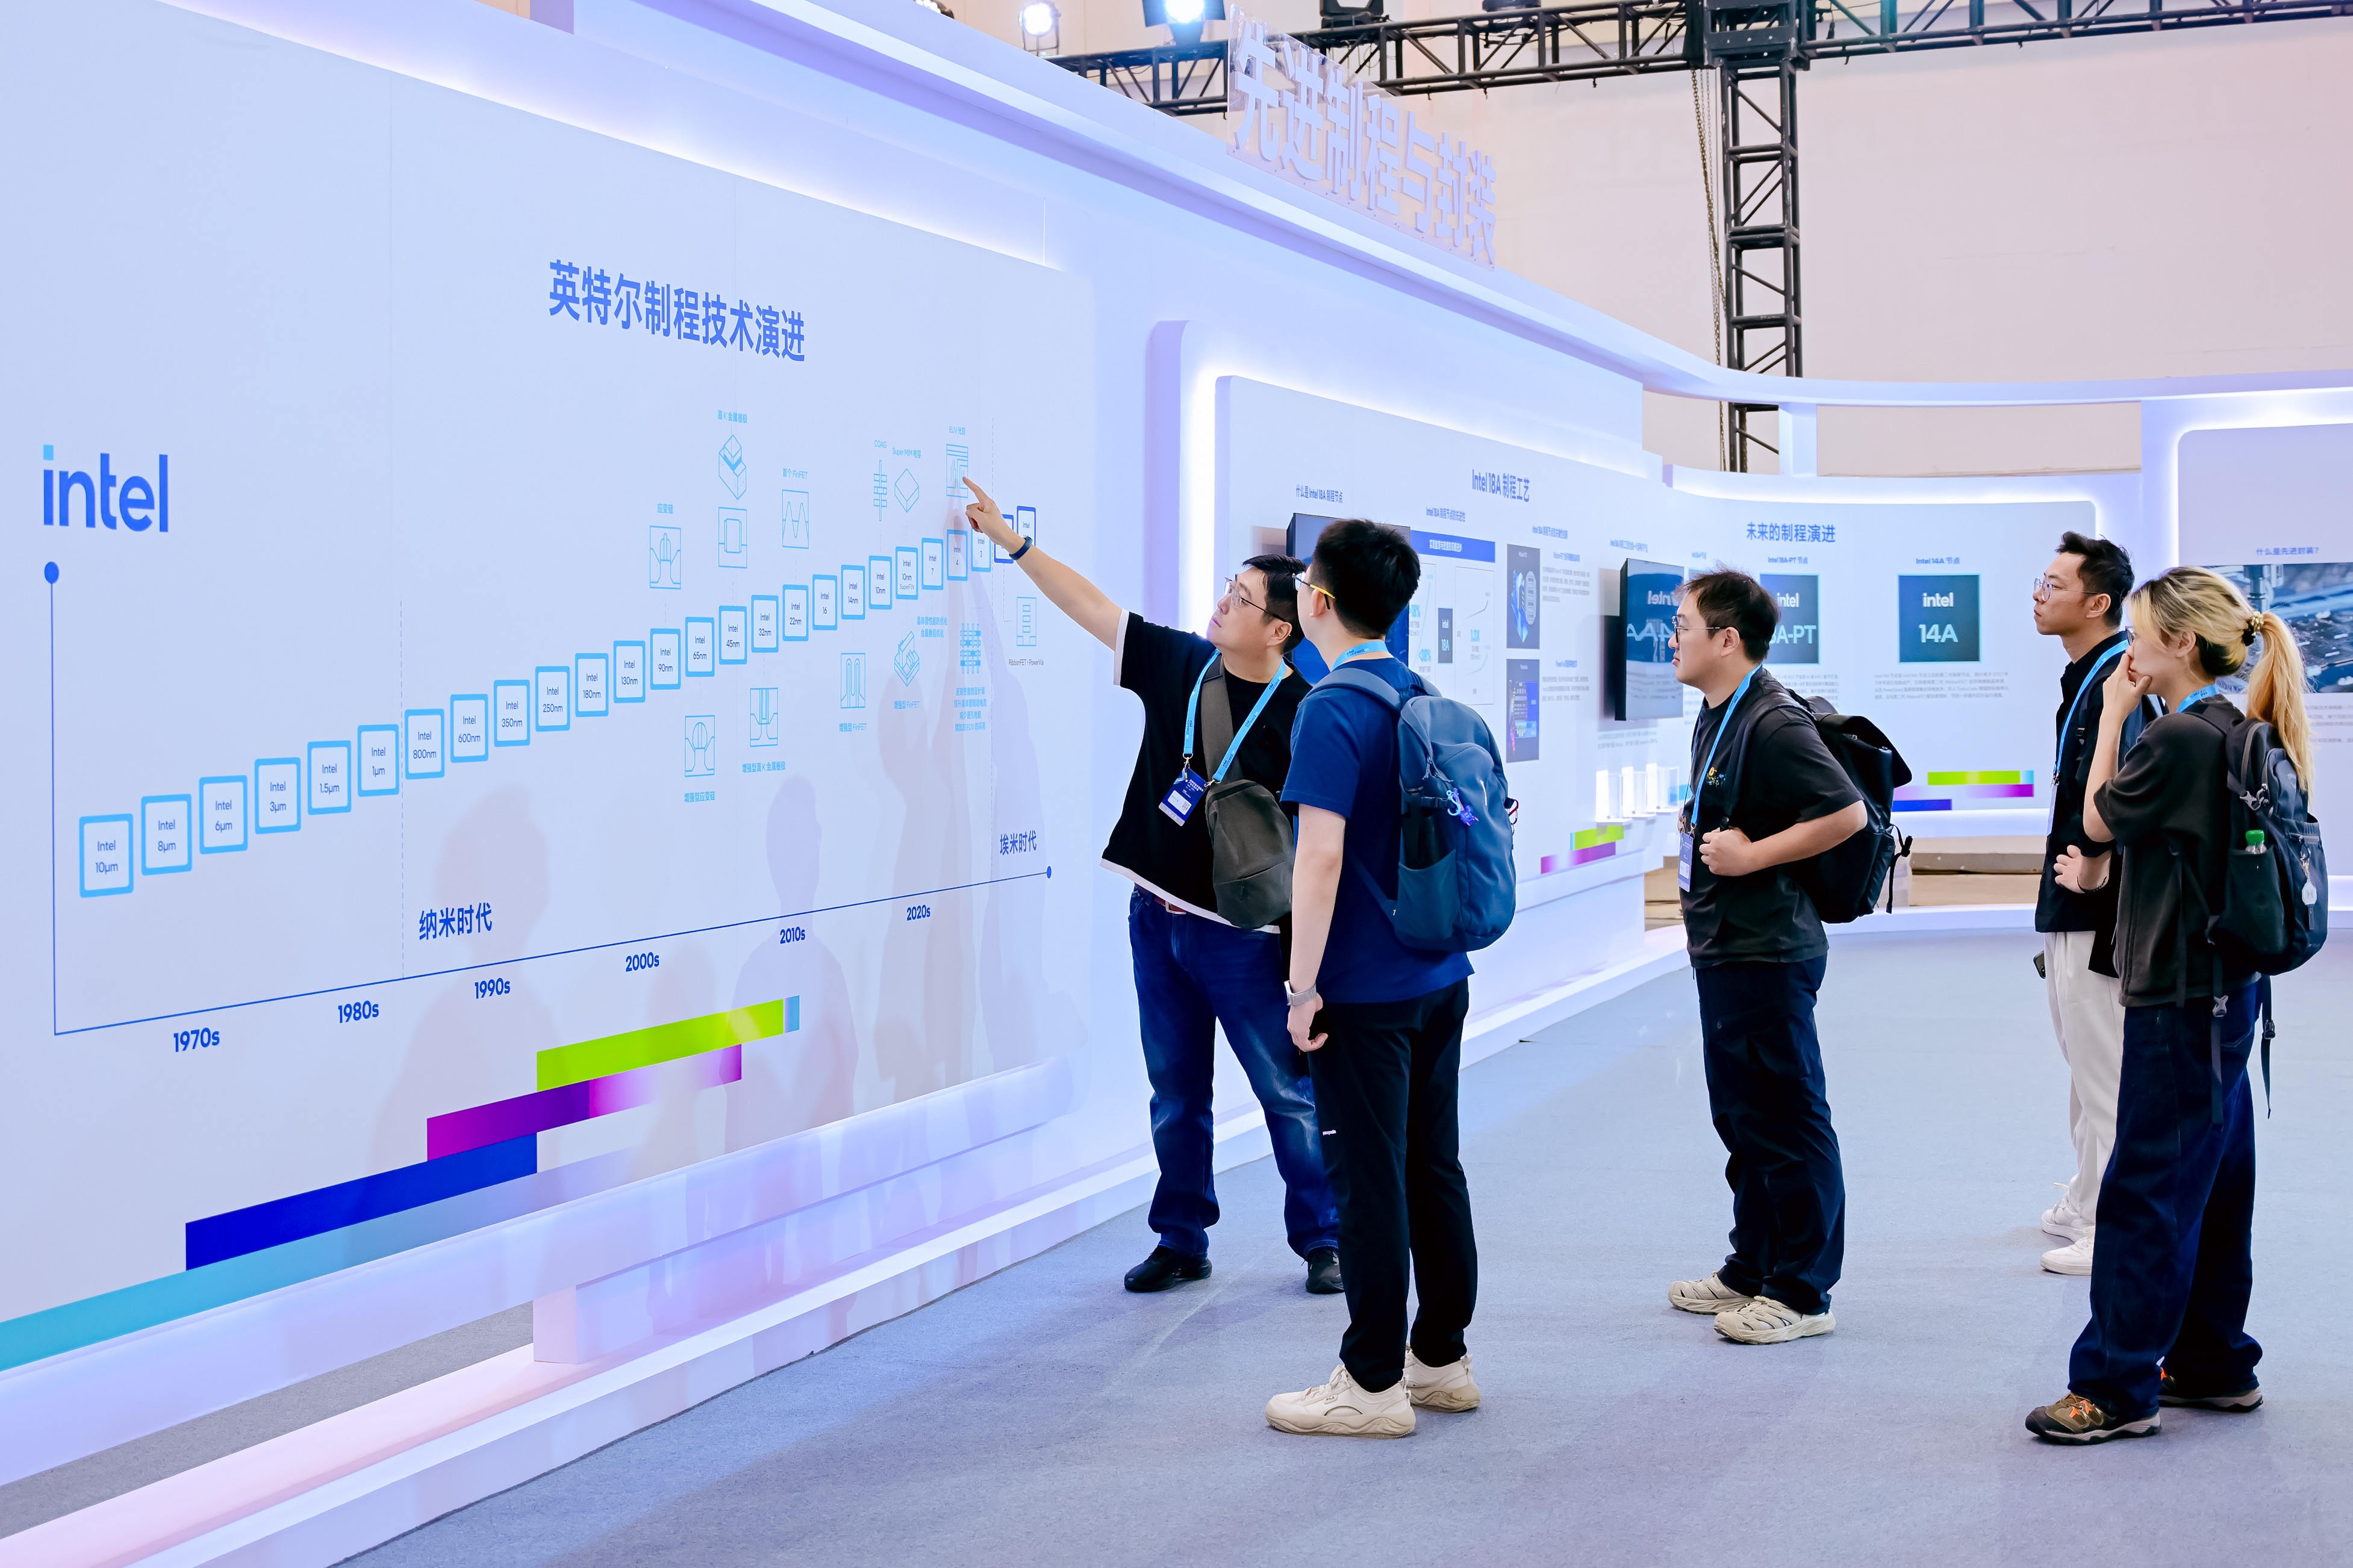
在物理AI领域,机器人需要与真实环境交互,实时感知与精准执行是核心痛点。英特尔副总裁兼端侧计算和物理AI事业部中国区总经理高嵩表示,希望英特尔成为物理AI领域的首选厂商。针对传统方案中感知、决策与控制单元分离导致的响应慢及协同偏差问题,英特尔提出“大小脑融合”方案,依托第三代酷睿Ultra的XPU异构架构,将推理决策与实时运动执行整合在单颗SoC上。
- CPU作为“小脑”:以4kHz频率每秒完成4000次动作调整,保障关节电机精准响应。
- GPU承载高阶推理:在Pi0.5精度下推理时延仅为78毫秒,低于人类视觉平均反应时间。
- NPU面向视觉感知:YOLOv12n推理仅需3.55毫秒,每秒处理约280帧,远超普通摄像头输出上限。
这种单芯片整合不仅降低了响应延迟,还通过硬件负载整合压缩了算力冗余和能耗,使具身智能的整体拥有成本进入可商业化区间。面对具身智能算法路线未统一的不确定性,英特尔采取开放架构策略,联合科通工业、神州数码等伙伴推出基于第三代酷睿Ultra平台的开发套件,并在制造、医疗、物流等场景推进项目量产。英特尔具身套件将于11月份在京东上线,进一步缩短开发者触达机器人的路径。
算力定义重写,系统级优化成为关键
英特尔的战略表明,在AI执行时代,系统设计的重心正向执行面迁移。在数字AI侧,x86架构在控制面、生态适配和基础设施软件上的存量优势,能够承接智能体部署带来的系统级工作需求;在物理AI侧,异构SoC缩短了机器人的感知-决策-控制闭环,通过生态广度对冲算法路线的不确定性。随着AI真正开始解决现实问题,提供最优的系统级算力选择,将成为提升生产力的关键因素,算力版图已然重塑。