
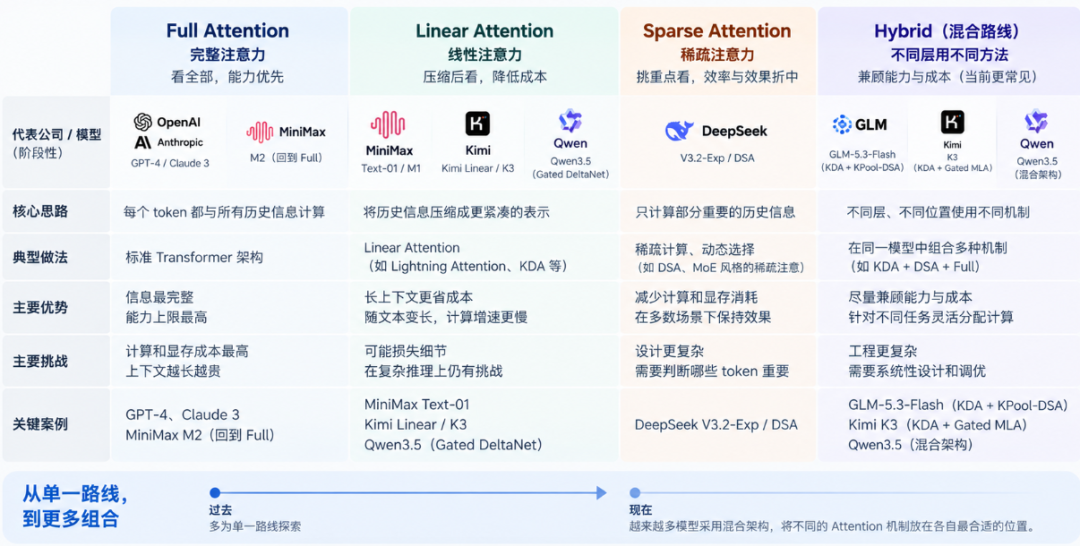
近期,GLM-5.3-Flash项目配置文件的公开显示,其45层架构中,34层采用基于Kimi路线的KDA线性注意力,另外11层采用基于DeepSeek路线的KPool-DSA稀疏注意力。这一架构细节揭示了大模型Attention机制正在经历从“分流”到“重组”的深刻变迁。今年以来,混合注意力架构中原本由全局Attention承担的角色,正逐渐被Sparse Attention(稀疏注意力)接替。理解这一变化,需回溯至Attention机制解决长序列信息检索与计算成本平衡的核心命题。
混合注意力的兴起与局限
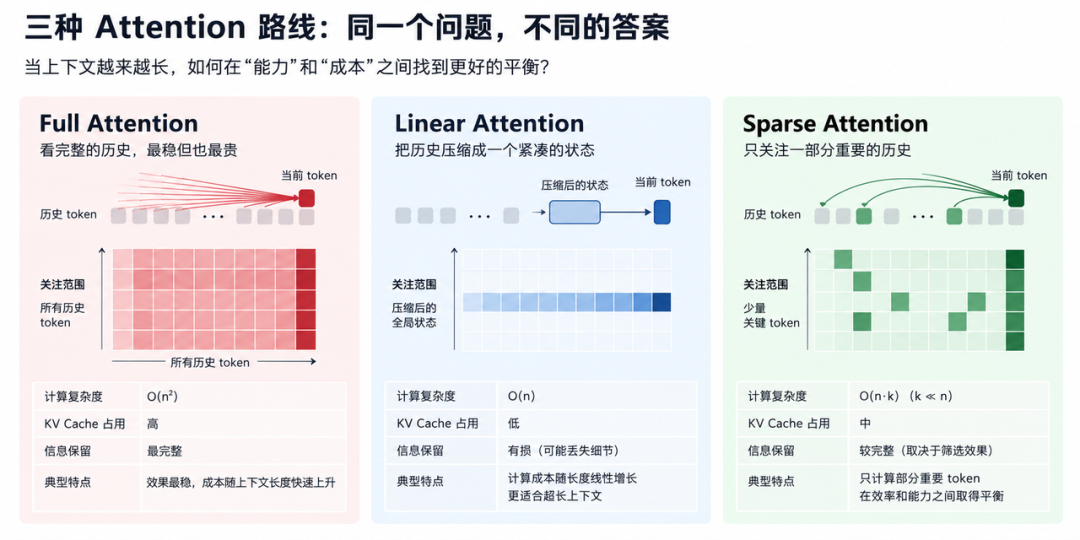
传统Transformer依赖全局注意力(Full Attention),虽信息保留充分,但计算与缓存成本随上下文长度线性增长。为在能力与成本间寻找平衡,行业转向混合注意力架构,即结合高效注意力(如线性或稀疏)与少量全局注意力。例如,Qwen3.8-Flash-Next将原本负责全局精确读取的Attention层改造为Qwen Sparse Attention。然而,早期混合架构仍保留全局注意力作为“保底”,以应对未知能力风险。
MiniMax的架构迭代路径
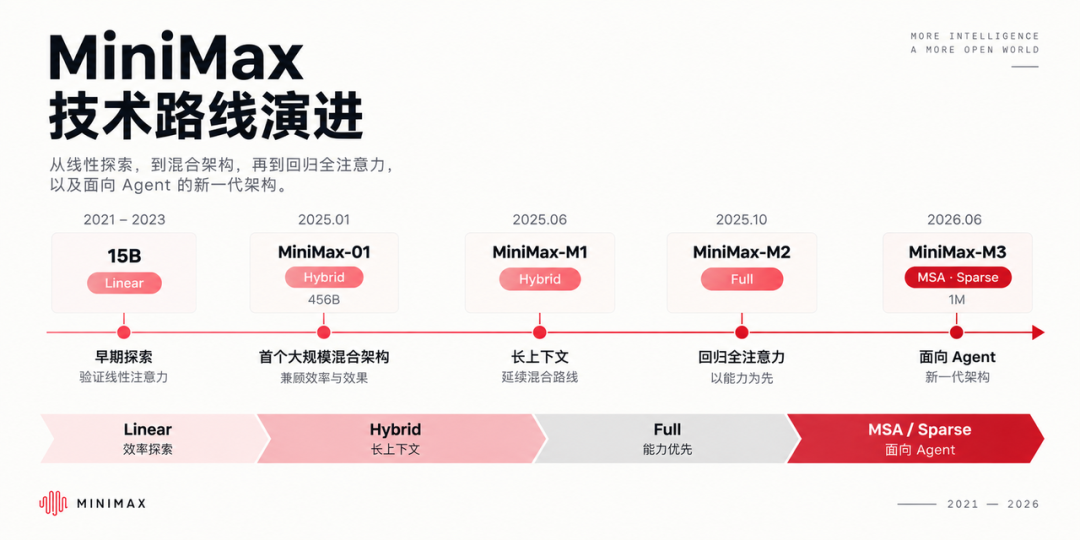
MiniMax的架构演进完整呈现了这一探索过程。2023年底,MiniMax押注线性注意力,训练4560亿参数的MiniMax-01。尽管线性注意力在长上下文检索上存在压缩损失,团队仍通过7:1的混合比例(7层Lightning Attention配1层Full Attention)保留全局注意力,以兜底未知能力缺口。然而,随着模型Scale扩大,混合注意力在多跳推理任务中暴露出比全局注意力更明显的能力损失。由于无法提前穷尽潜在的能力缺口,MiniMax在M2阶段回归Full Attention,以换取更可预期的工程行为与能力边界。
Agent场景重塑成本结构
2026年6月发布的M3模型再次转向自研的MiniMax Sparse Attention(MSA),核心驱动力来自Agent场景的需求变化。在Agent应用中,上下文不再是静态文档,而是随任务执行不断累积的工作历史,包括搜索结果、代码及工具返回等。这种长程、动态的上下文使得Full Attention的计算与KV Cache成本急剧放大。MSA通过从长上下文中筛选关键信息参与计算,避免了每一步处理完整历史的高昂开销,从而在保持能力的前提下,解决了复杂Agent任务中的“Context Scaling”问题。
从MiniMax的反复调整可见,大模型架构的选择已非静态的技术路线,而是随任务场景(如从静态文本到动态Agent)动态演进的工程决策。稀疏注意力正逐步取代全局注意力,成为平衡长上下文成本与复杂推理能力的新标准,标志着大模型底层架构进入精细化重组阶段。