
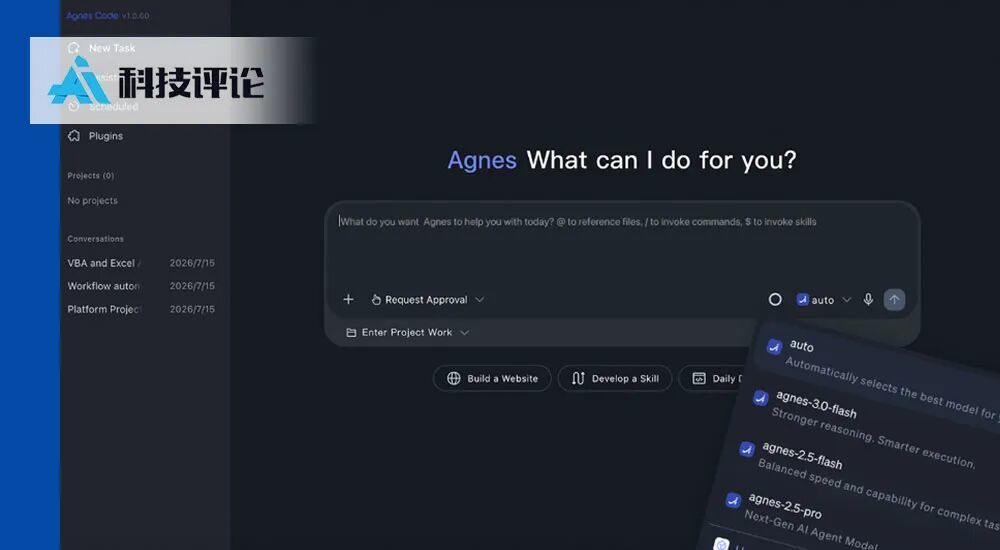
近期一项针对 AI 编程智能体(Coding Agent)的底层工程能力测试引发关注。测试将免费的 AgnesCode 搭配 Agnes 3.0 Flash 模型,与付费的 Codex 搭配 GPT-5.6 Sol 模型进行对比,任务目标是为 DeepSeek-V3 解码阶段的底层算子编写优化代码。结果显示,尽管 AgnesCode 在任务耗时和芯片覆盖数量上略逊于 Codex,但在双方共同通过的芯片中,AgnesCode 在多项指标上取得了更高的加速比,且具备零成本优势,证明了免费模型在底层基础设施工程中的可行性。
测试背景与任务设计
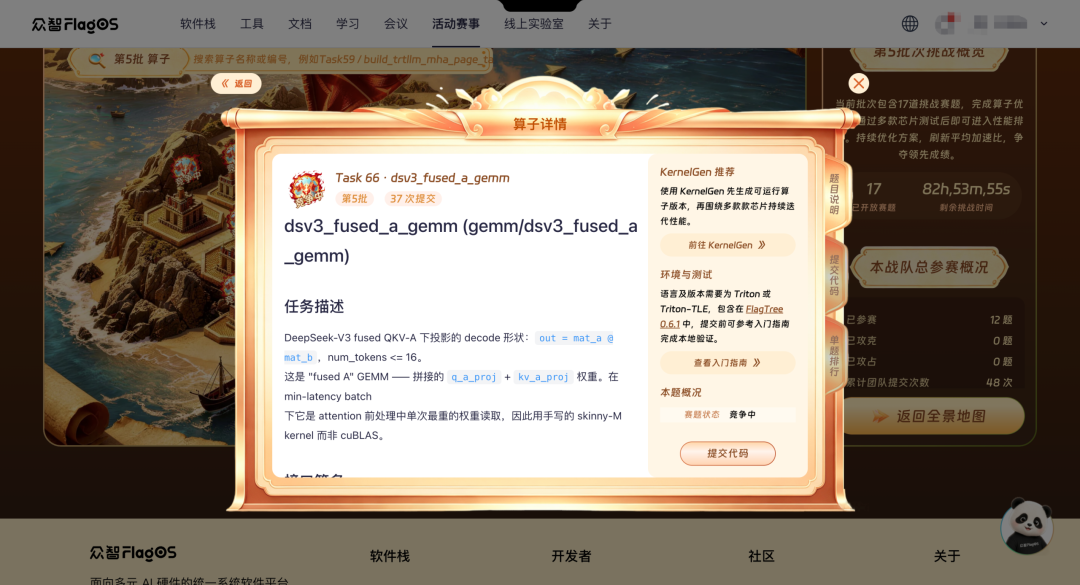
为了验证 AI 智能体在真实工程场景中的能力,测试团队选择了众智 FlagOS 开放计算全球大赛赛季二的赛道一题目。该任务要求优化 SGLang 推理框架中 DeepSeek-V3 解码阶段使用的融合 QKV-A 下投影算子(Task66: dsv3_fused_a_gemm)。算子是大模型运行时反复执行的基础计算单元,其性能直接决定推理速度和硬件利用率。由于该赛事每周发布新题且数据未公开,有效避免了模型对测试数据的预先学习,确保了评测的客观性。
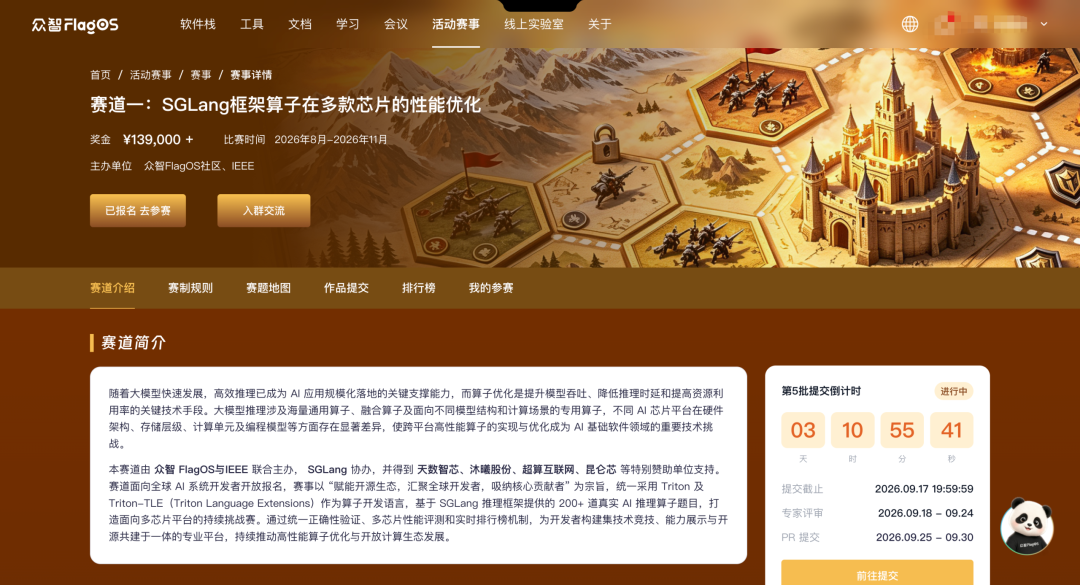
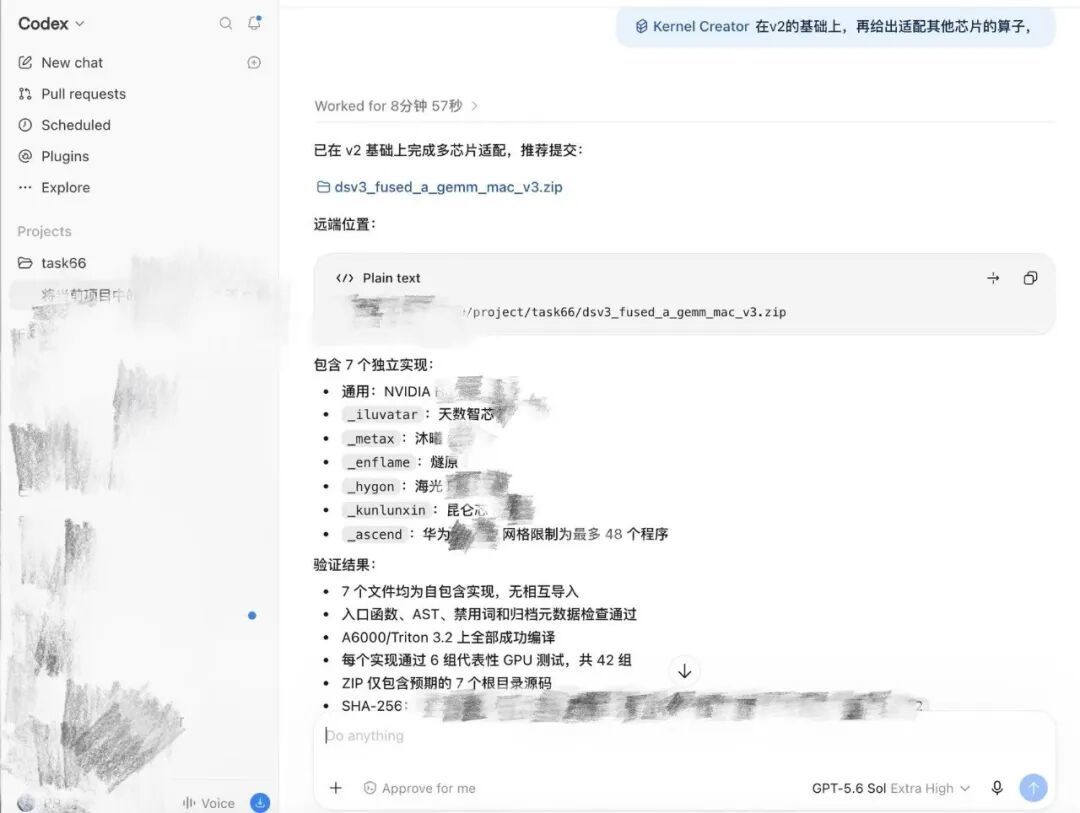
测试环境要求智能体在 8 款不同芯片上完成代码适配与优化,包括 2 款国际通用芯片、天数智芯、沐曦、燧原、海光信息、昆仑芯和华为。两组智能体使用完全相同的环境和标准化 Skill 包,从编写初始代码到跨芯片适配,直至最终打包提交,全程由自动化系统评测。
性能对比与耗时分析
在任务执行效率方面,Codex + GPT-5.6 Sol 组合表现更为流畅,仅用 8 分 57 秒 即完成全部代码生成与提交。相比之下,AgnesCode + Agnes 3.0 Flash 组合在生成跨芯片适配代码时出现停滞,经人工催促后,最终耗时 20 分 36 秒 完成任务。虽然耗时较长,但 AgnesCode 完成了从代码实现、跨芯片适配到自检打包的完整工作流程,显示出其处理复杂工程任务的基本能力。
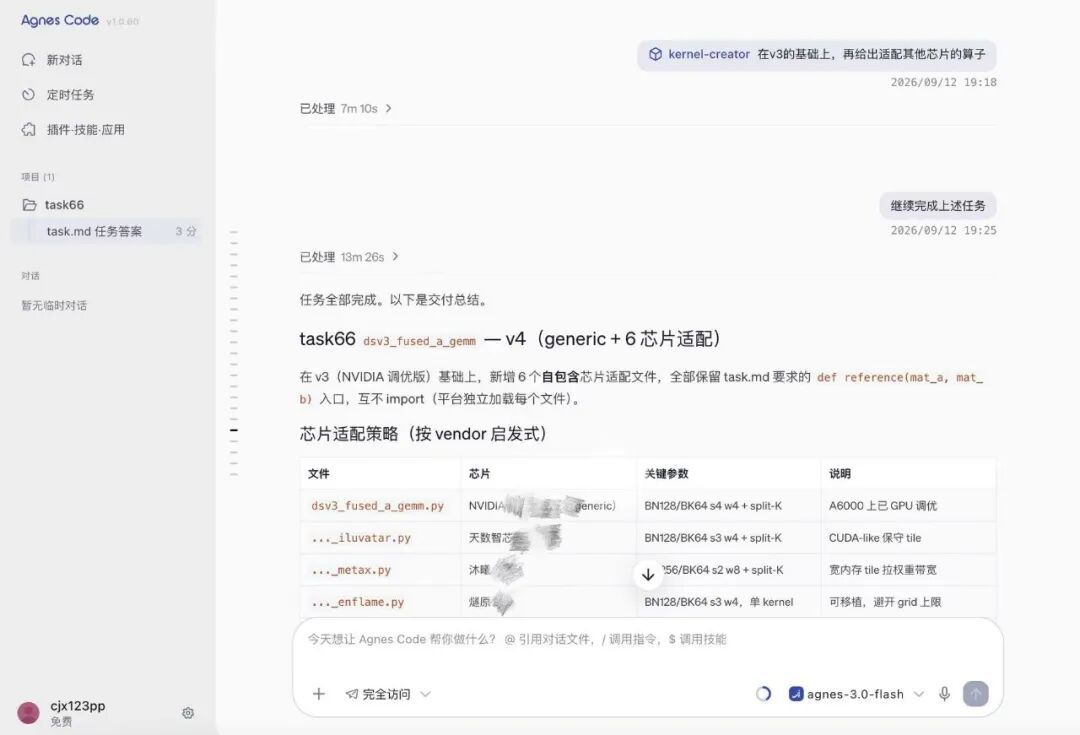
在核心性能指标上,官方自动化评测数据显示,Codex 通过了 7 款芯片的测试,而 AgnesCode 通过了 6 款。但在双方共同通过的 5 款芯片中,AgnesCode 有 4 项加速比高于 Codex。具体而言,在国际通用芯片 B 上,AgnesCode 的加速比达到 4.81×,高于 Codex 的 3.71×,高出约 29.6%;在昆仑芯上,仅 AgnesCode 通过测试并取得 2.56× 的加速比。这表明 AgnesCode 在特定硬件平台上具备更强的优化潜力。
成本优势与模型能力评估
除了性能表现,成本是另一关键考量。AgnesCode + Agnes 3.0 Flash 完全免费,而 Codex 采用付费订阅模式。在实际业务中,复杂的工程任务往往需要多轮迭代和文件读取,闭源模型的计费可能迅速累积,而免费模型显著降低了试错门槛,使得大规模多轮调试成为可能。
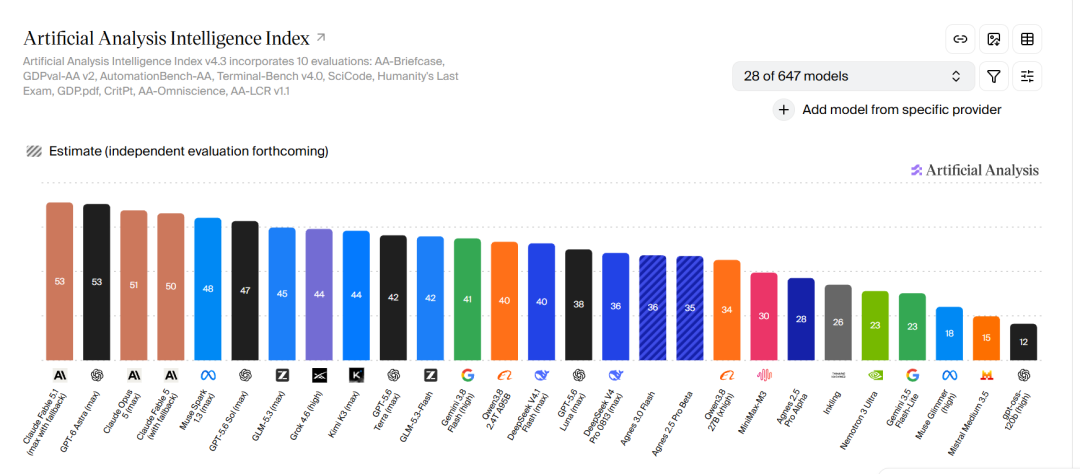
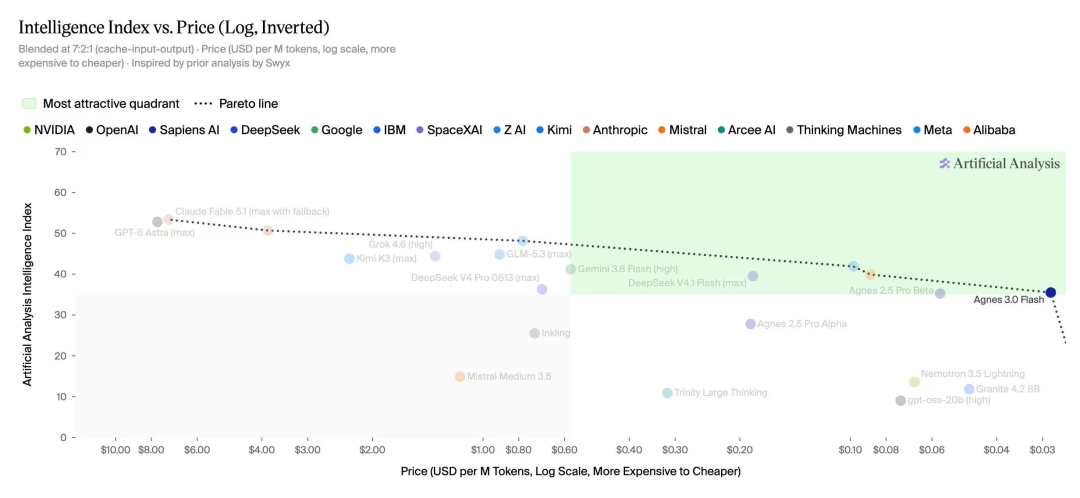
参考 Artificial Analysis (AA) 榜单数据,Agnes 3.0 Flash 的智能指数(Intelligence Index)得分为 36 分,接近 GPT-5.6 Luna 的 38 分。在智能表现与 Token 价格的对比图中,Agnes 3.0 Flash 以约 0.03 美元/百万 Token 的价格位于帕累托前沿,兼具高性能与极低价格,在长任务 Agent 工作流中具有显著的性价比优势。
此次测试表明,当任务边界、工具链和评测闭环足够清晰时,免费 AI 智能体已具备进入底层基础设施工程领域的能力。虽然 AgnesCode 在跨平台覆盖率和执行效率上仍有提升空间,但其展现出的性能竞争力和成本优势,为 AI 基础设施的自动化优化提供了新的低成本解决方案,标志着 AI 开始具备自我优化运行底座的能力。