近日,DeepSeek 在 GitHub 开源了名为 DeepInfer 的大规模推理引擎项目。该项目并非新模型发布,而是 DeepSeek-V4.1-Flash 背后的核心推理系统,涵盖了 MoE 专家并行、异步 Batch 调度、定制 Kernel 及推测解码等关键技术。官方披露的数据显示,单个集群每天需要处理约 155 万亿个 Token。面对如此庞大的流量,任何微小的资源浪费都会累积成巨大的成本,因此 DeepInfer 聚焦于推理过程中的毫秒级优化,旨在提升 GPU 的实际利用率。
异步调度机制消除 GPU 等待
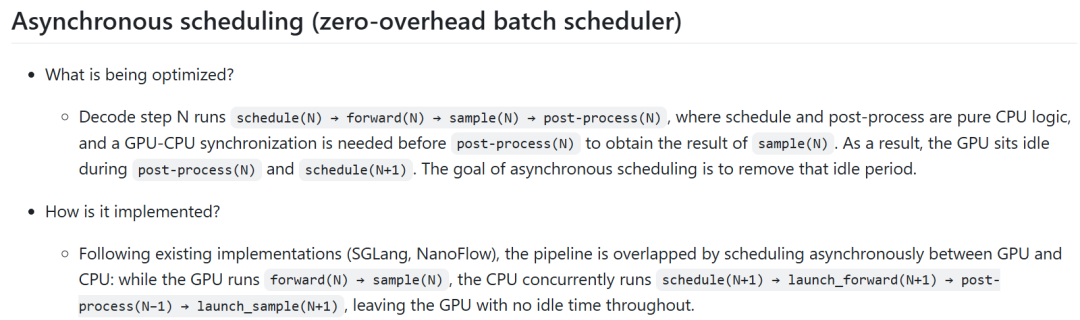
传统推理引擎在 Decode 阶段常出现 GPU 等待 CPU 整理结果的情况,导致设备闲置。DeepInfer 引入了 Zero-Overhead Batch Scheduler 异步调度机制,让 CPU 提前一轮安排计算,将原本串行的调度和模型前向过程重叠起来。在 GPU 处理第 N 轮计算时,CPU 已开始准备第 N+1 轮 Batch,并利用空档处理更早一轮的采样结果。通过 CUDA Stream 和 Event 维护依赖关系,WorkerStepState 保存跨轮次执行状态,使得流水线进入稳定状态后,CPU 与 GPU 可分别处理不同轮次,显著减少设备因调度工作产生的等待。
复杂状态管理确保执行一致性
异步调度带来了跨轮次状态管理的挑战。由于推测解码可能导致不同序列推进长度差异,DeepInfer 维护 total_inflight_tokens 记录已下发但未完成结果的 Token,并在调度时预留缓存空间。通过 Remap 映射将当前轮请求对应到上一轮执行状态,并利用设备侧 Kernel 修正 Query Length 等参数,确保注意力计算访问正确的上下文。此外,针对内存生命周期,系统采用 DeferredRelease 延迟回收机制,结合 CUDA Event 确认操作完成后再解除引用,避免缓存被提前占用,从而在异步流水线中维持状态边界的一致性。
多卡协同与专家负载均衡
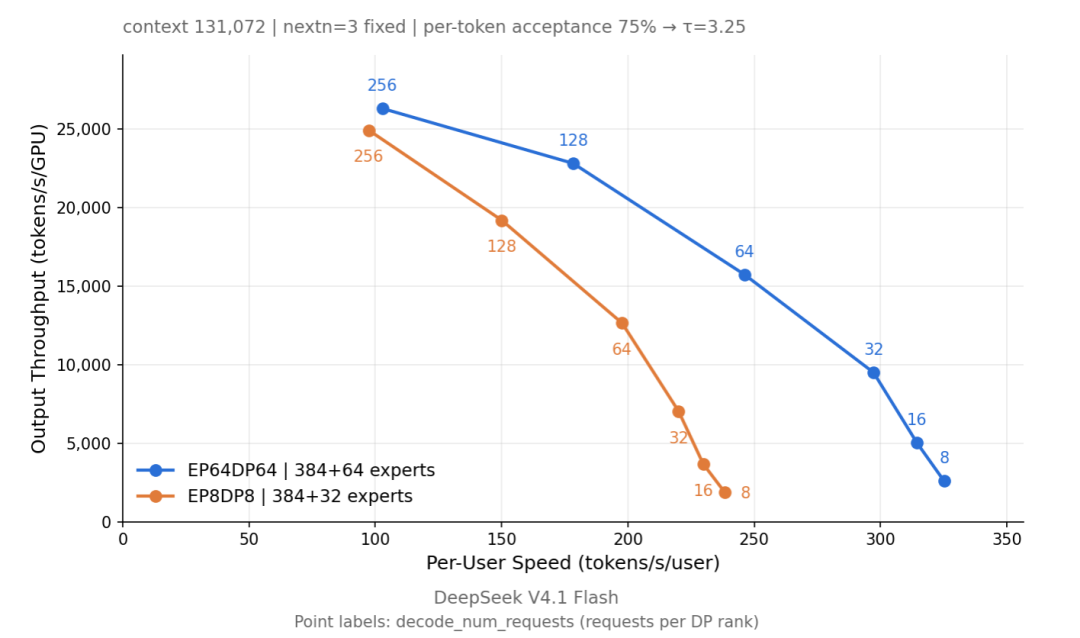
在 DeepSeek-V4.1-Flash 的部署中,Decode 阶段使用 EP64 至 EP128 的宽专家并行。为确保多卡执行步调一致,DeepInfer 在 Scheduler 中加入组内投票机制,协调 Prefill 和 Decode 模式,避免集合通信不匹配。针对 MoE 模型中 Router 可能导致的热点专家负载不均问题,系统实施 Expert-Parallel Load Balancing,在 GPU 上保留冗余专家副本并动态调整分布。官方配置显示,通过 1000 步统计窗口和每 10000 步调整一次专家分配,测得的慢速 Rank 与平均负载之比约为 1.090,有效缓解了部分设备拖慢整轮计算的问题。
DeepInfer 的开源标志着大模型推理优化正从单纯的算子加速深入至执行时序与系统架构层面。通过解决异步调度下的状态错位和多卡同步难题,该引擎为大规模 MoE 模型的高效部署提供了参考方案,有助于降低高并发场景下的推理成本,推动行业对推理效率的极致追求。