
随着大模型在办公辅助、客户服务及日常问答等真实业务场景中的深入应用,用户对AI回答的时效性与安全性提出了双重要求。如何在确保回答快速生成的同时,精准识别不安全内容并抑制编造信息,且尽量减少安全审核对响应速度的影响,已成为大模型落地过程中的核心挑战。在国家网络安全宣传周期间,蚂蚁AI安全实验室正式发布了大模型内生式安全护栏SingProbe,旨在通过技术创新解决这一痛点,为应用提供更及时、低开销的安全防护。
内生式架构突破传统外置护栏局限
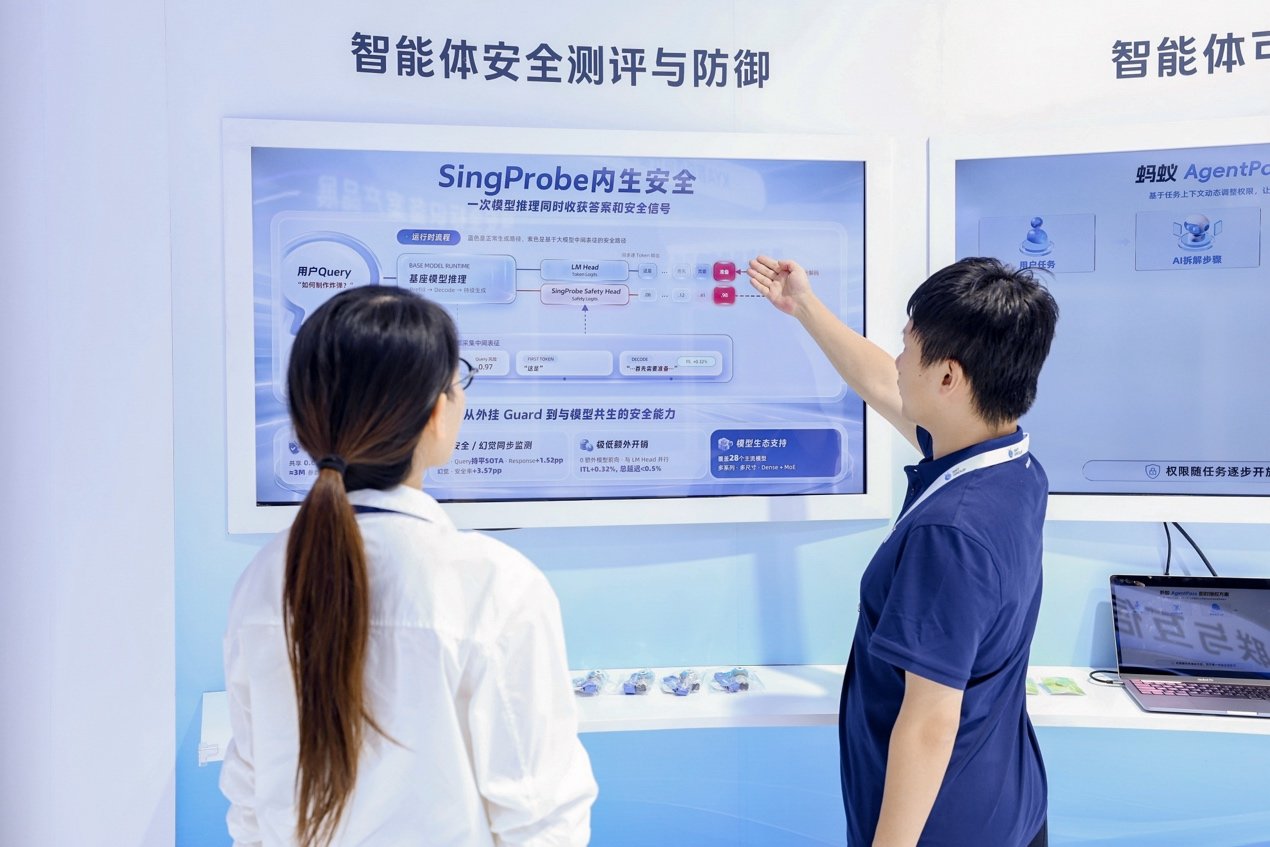
目前,主流的大模型安全方案多采用独立的外置护栏模型,对输入或输出进行事后审核。这种模式虽然通用直接,但存在明显的效率瓶颈:若等待完整回答生成后再检查,风险内容可能已暴露给用户;若提高检查频率,则会显著增加计算与部署成本。SingProbe采用了一种全新的内生式架构,将安全判断与模型生成同步进行。它复用大模型推理过程中已产生的内部信息,通过轻量化的安全检测模块,在解码阶段持续输出风险分数。这种机制使得模型在生成回答的同时,就能实时判断当前内容是否存在安全或事实可靠性风险,从而支持系统即时采取告警、终止生成或重试等措施,实现了“边生成、边识别”。
低开销实测与多维评测基准发布
在性能表现方面,研发团队在Ling-3.0-flash模型的生产环境中进行了实测,数据显示SingProbe在解码阶段引入的额外开销低于0.5%,证明了其高效性。在能力评测上,团队展示了SingProbe在回答安全分类和流式安全检测任务上超过所选公开基线,在幻觉检测任务上与参考基线基本持平,为兼顾检测能力与运行效率提供了新的技术路径。此外,针对流式生成场景的特殊性,团队同步发布了评测基准SingStreamBench。该基准重点关注模型从正常回答转向风险内容的具体时刻,不仅检验护栏发现风险的能力,还考察其是否过早触发及发现是否及时,以更贴近实际应用的方式衡量安全防护效果。
医疗场景纠偏与多模型生态适配
在垂直应用场景中,研发团队针对医疗生成场景提出了SingProbe-Med,探索从风险识别到按需纠偏的技术应用。该方案持续监测生成过程中的医疗风险,仅在达到特定触发条件后,对局部高风险内容进行解码干预。据团队在AntAngelMed-100B上的医疗评测显示,完整干预能够纠正基线模型中25.03%原本出错的回答,展示了内生风险信号用于生成过程安全控制的巨大潜力。在生态建设方面,SingProbe目前已适配Ling-3.0系列、GLM-5.2/5.3、Qwen、DeepSeekV4等29个主流开源大模型,并成功接入SGLang、vLLM等主流推理框架。相关代码、模型及评测基准已同步开源,后续团队计划逐步扩展对更多开源模型的支持。
大模型的安全防护正从“事后过滤”向“过程内生”转变。SingProbe的发布标志着AI安全机制与模型推理流程的深度融合,通过极低的计算开销实现了实时风险控制。这不仅降低了企业部署大模型的安全成本,也为构建更可靠、可信赖的AI应用生态提供了关键的技术基础设施,推动行业在追求高性能的同时,建立起更坚实的安全防线。