OpenAI 早期机制可解释性研究科学家 Nick Cammarata 近日发表了一篇时长约 65 分钟的深度长文《Neural Networks Are Already Clean》,正式推翻了自己十年前关于神经网络是“黑箱”的结论。这项研究基于更先进的自动化解释算法和 Agent 团队,发现现代视觉模型中最后一层 99%~100% 的神经元都能找到清晰的解释。这一发现挑战了 AI 可解释性领域过去十年主导的“叠加假说”及稀疏自编码器(SAE)等拆解工具的有效性,认为神经网络内部存在连贯且可被人类直接阅读的组织结构,而非混乱的特征纠缠。
从“黑箱”到“清晰”:观测工具的迭代
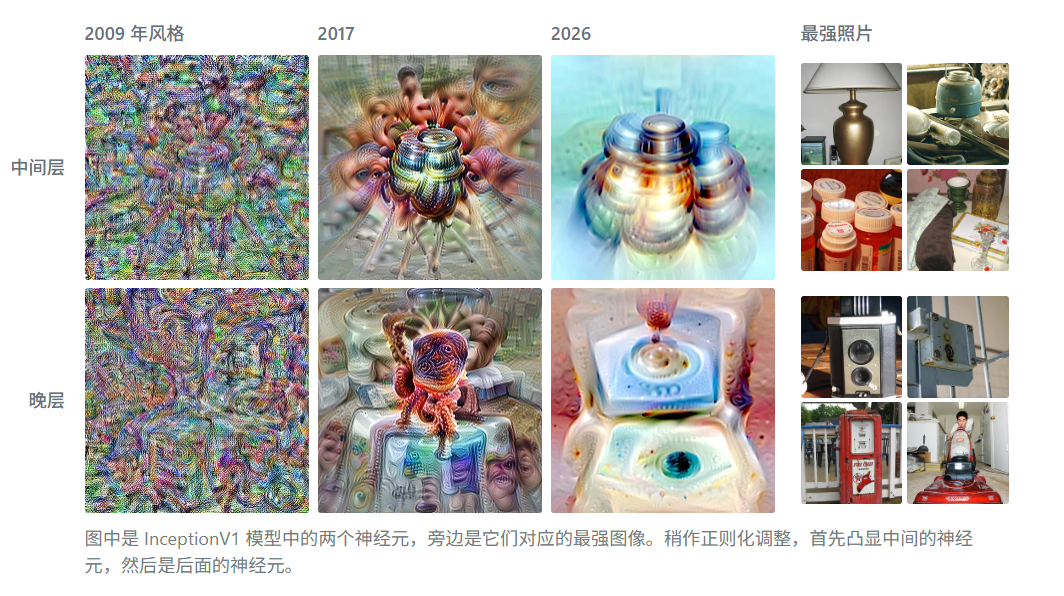
2014 年的 InceptionV1 模型曾被视为可解释性研究的“模型生物”,其深层神经元被认为难以解读,尤其是编号 4e:55 的神经元同时被猫脸和汽车车头激活,被视为“叠加”现象的典型证据。当时学界估计最后一层可解释的神经元仅占 5%。然而,Cammarata 指出,这种混乱可能源于早期观测工具的局限。2023 年,他在 OpenAI 进行的大规模自动化神经元解释项目显示,使用现有工具仅能解释约 2% 的神经元。三年后,随着算法升级,特别是引入激活路径引导和正负两极交叉验证法,观测结果发生了根本性变化。
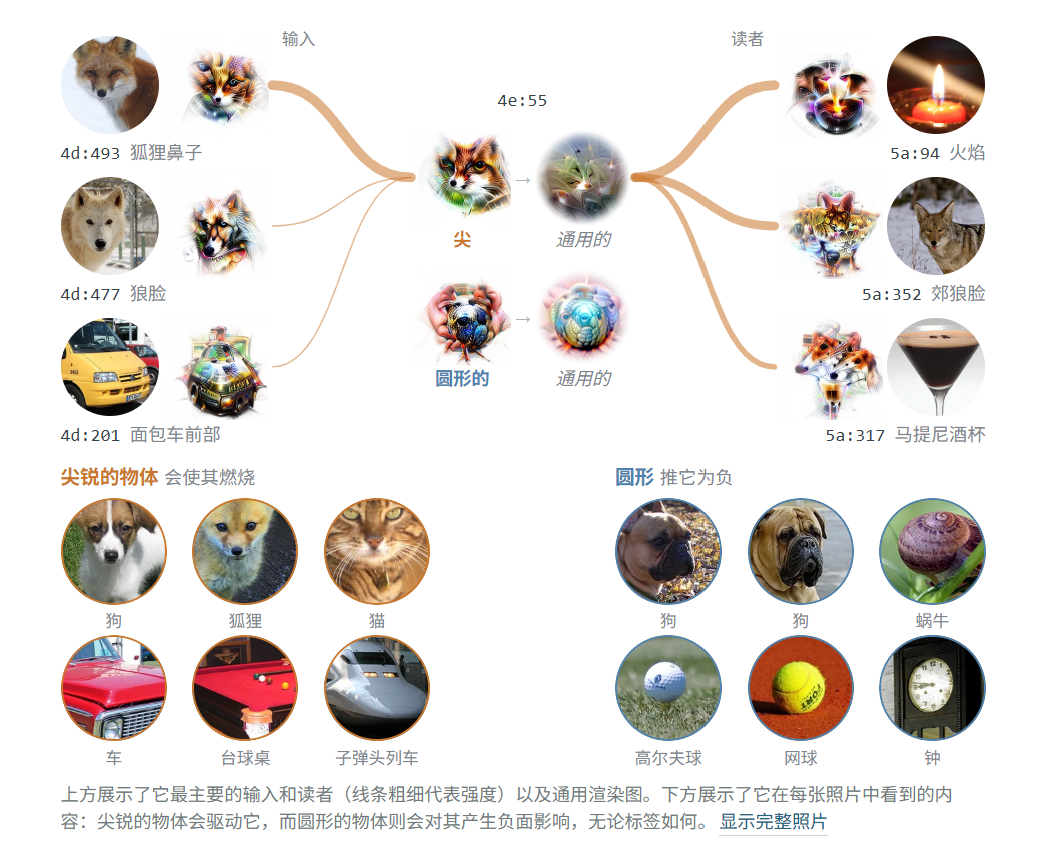
- 激活路径引导:通过微调正则化参数,强制算法沿真实图像的天然激活路径合成特征,剥离算法产生的“奖励作弊”噪音。
- 正负两极交叉验证:同时研究最强激活(正极)和最强抑制(负极)的特征,共同锚定神经元的真实功能。
在新工具下,InceptionV1 的可解释率大幅提升,而现代架构如 ConvNeXt 的最后一层神经元几乎全部清晰可读。
经典案例“翻案”:几何特征与递归泛化
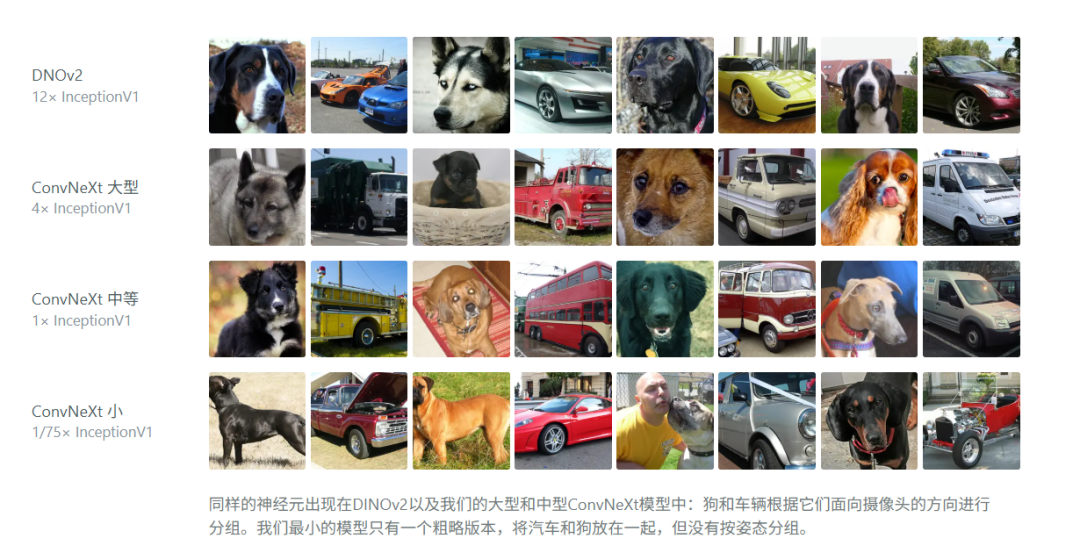
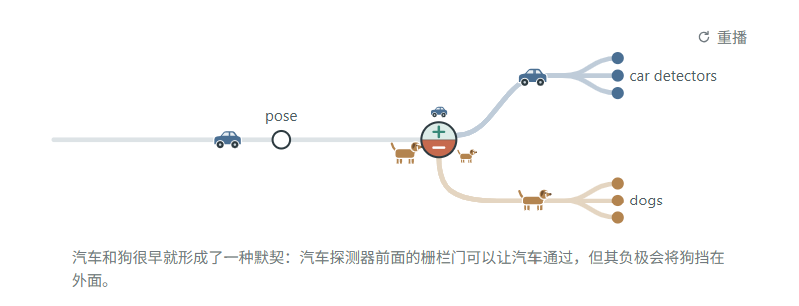
研究重新审视了两个经典案例。首先是“猫与汽车神经元”,新观测显示该神经元并非识别动物或车辆,而是检测 V 字几何形状。狐狸的尖脸、喷射的火焰、汽车的尖头都会激活其正极,而圆形物体则激活其负极。其次是“汽车与狗神经元”,研究发现这组神经元实际上检测的是“物体是否正脸直接面对镜头且两侧对称”。汽车特征被打上“正面朝前”标签后,会分流至下游真正的汽车或狗分类电路。这一发现表明,所谓的“多义性”并非神经元功能的混乱,而是特征沿信号进行连续泛化与分流的结果。
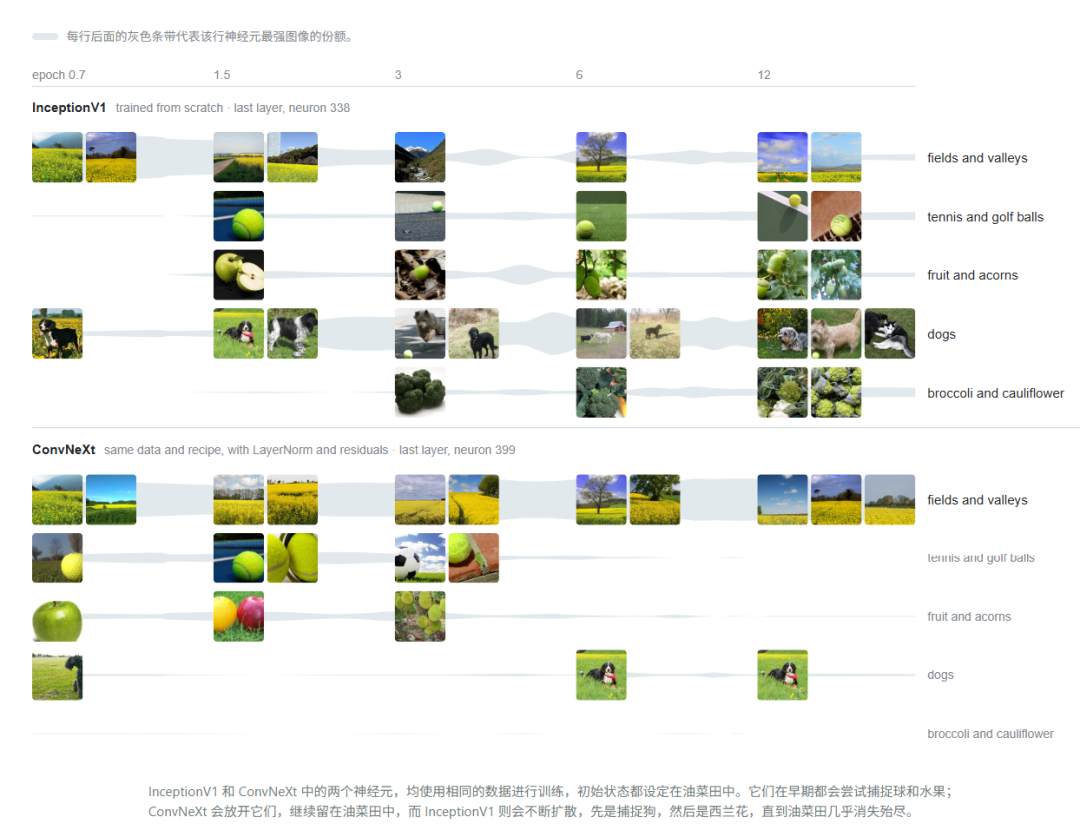
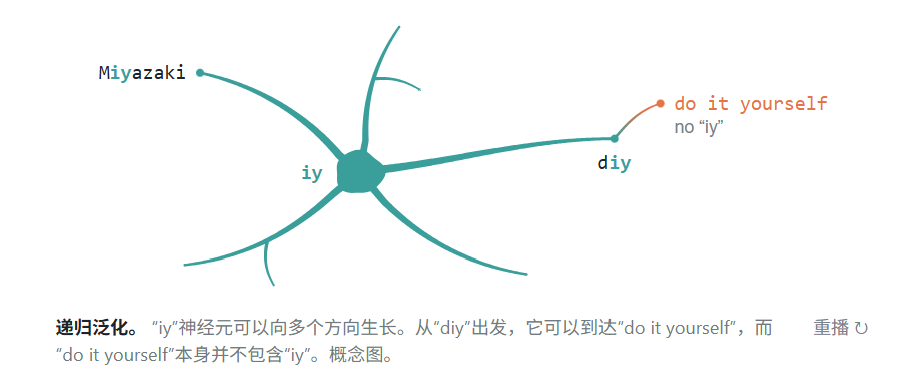
Cammarata 提出“递归泛化”来解释这一现象。他认为神经元像树枝一样生长,从识别特定物体(如油菜花)沿特征轴(如黄色、圆形)延伸,最终覆盖更广泛的语义空间。在语言模型中,检测“iy”发音的神经元可延伸至识别“Do it yourself”等短语。这种高维逻辑下的语义延伸,常被人类误读为逻辑混乱。
压力实验与行业影响
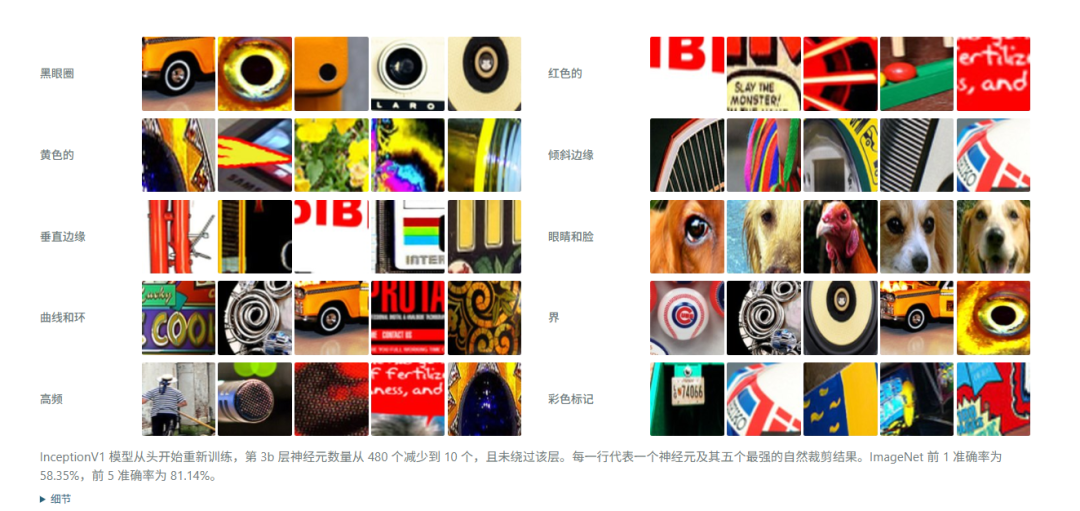
为验证“叠加假说”,Cammarata 对 InceptionV1 的 3b 层进行了极限压力实验,将原本 480 个检测曲线的神经元压缩至 10 个(48 倍压缩)并重新训练。结果显示,这 10 个神经元依然清晰可解释,只是每个神经元负责的范围更宽,例如合并了多个角度的曲线检测器。此外,经 SAE“解缠”后的特征响应宽度反而比原始神经元更粗,暗示 SAE 可能制造了数学假象。这一结论若成立,将意味着过去十年依赖 SAE 分解的研究路径可能偏离了本质,AI 对齐有望从探索性研究转变为基于清晰机制的“常规科学”。